Filigrane Claude : le watermark invisible expliqué (2026)
Depuis le 2 août 2026, les textes générés par les nouveaux modèles Claude portent un filigrane invisible, et les fichiers produits sont signés par des métadonnées de provenance. Concrètement, votre œil ne voit rien, mais un algorithme muni de la bonne clé peut estimer qu’un texte a été rédigé par Claude.
Ce marquage repose sur deux mécanismes distincts : un signal statistique intégré au choix des mots (la méthode SynthID-Text de Google DeepMind) pour le texte, et le standard C2PA pour les fichiers. Il découle des engagements de transparence pris dans le cadre de l’EU AI Act. Voici comment cela fonctionne réellement, ce que ça change pour vous, et ce que valent les outils qui promettent déjà de le retirer.
Ce qu’est le filigrane Claude, en une phrase
Le filigrane Claude est un marqueur invisible qui certifie qu’un contenu a probablement été généré par Claude, sans altérer sa lisibilité ni révéler d’information personnelle.
Anthropic a détaillé le dispositif le 14 août 2026, après une première annonce le 11 août. Deux briques coexistent :
- Pour le texte : un filigrane statistique de type SynthID-Text, intégré directement dans la séquence des mots.
- Pour les fichiers (images, .png, .jpg, .svg) : une note cryptographiquement signée ajoutée aux métadonnées, selon le standard C2PA.
La distinction est importante. Dans le premier cas, le texte lui-même porte le signal. Dans le second, le contenu du fichier ne change pas : c’est une étiquette de provenance apposée à côté.
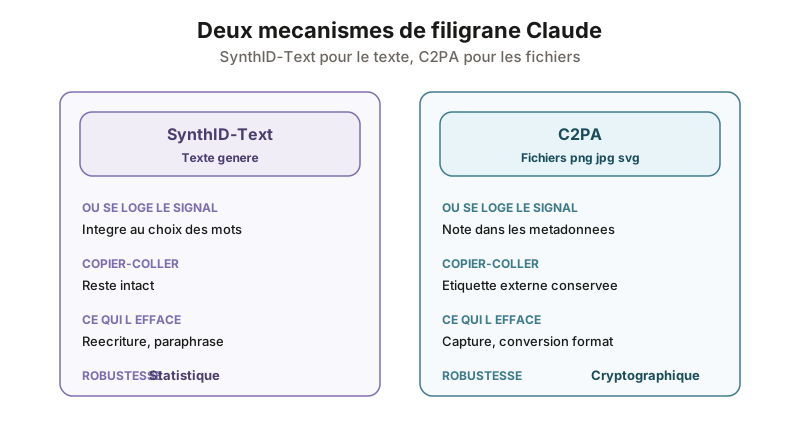 Deux briques distinctes : le signal SynthID-Text voyage avec le texte copié, tandis que l’étiquette C2PA disparaît si les métadonnées du fichier sont retirées.
Comment fonctionne SynthID-Text sur le texte
SynthID-Text ne cache pas de caractères invisibles dans le texte : il biaise imperceptiblement le choix des mots de Claude.
C’est le point le plus mal compris de tout le sujet. Beaucoup imaginent des espaces de largeur nulle (U+200B) ou des caractères Unicode dissimulés. Ce n’est pas le cas : un tel marquage serait repérable et effaçable en quelques secondes. Le mécanisme réel est bien plus subtil.
Un signal caché dans les choix de jetons
Quand Claude rédige, il choisit chaque mot parmi plusieurs candidats presque équivalents. Là où le sens ne change pas, plusieurs synonymes conviennent. SynthID-Text utilise une clé et les quelques mots précédents pour orienter ce choix « à faible enjeu » vers certaines options plutôt que d’autres.
Vu de l’extérieur, les mots restent aléatoires et naturels. Mais un vérificateur muni de la clé peut analyser la séquence et mesurer si elle correspond aux choix qu’aurait faits Claude. Sur un texte assez long, l’écart statistique devient significatif. Cette approche s’appuie sur une proposition de Scott Aaronson formulée en 2022, formalisée par Google DeepMind dans la revue Nature en 2024.
Où le signal est fort, où il est faible
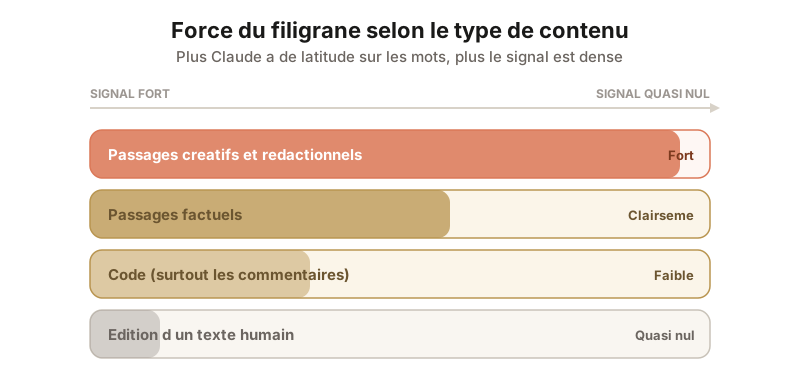 La densité du filigrane suit la latitude lexicale de Claude : forte en rédaction créative, quasi nulle quand vous éditez un texte déjà humain.
Le filigrane n’est pas uniforme. Il est dense là où Claude a beaucoup de latitude lexicale, et clairsemé là où il en a peu.
- Passages créatifs et rédactionnels : marquage fort, car de nombreux mots interchangeables sont disponibles.
- Passages factuels : marquage clairsemé, car changer un mot risquerait d’altérer l’exactitude.
- Code : marquage faible, l’essentiel du signal se logeant dans les commentaires plutôt que dans la logique fonctionnelle.
- Édition d’un texte humain : marquage quasi nul, puisque presque tous les mots sont ceux de la personne, pas de Claude.
Selon les tests d’Anthropic et de Google DeepMind, ce marquage n’entraîne aucune différence statistiquement significative de qualité, de créativité ou de lisibilité. Il n’ajoute pas de jetons, ne change pas le prix de service et n’a qu’un impact négligeable sur la vitesse de génération.
Les métadonnées C2PA sur les fichiers
Pour les fichiers, Claude n’utilise pas SynthID-Text mais le standard C2PA, qui inscrit une signature de provenance dans les métadonnées.
C2PA (Coalition for Content Provenance and Authenticity) est un standard ouvert déjà employé par des fabricants d’appareils photo et des logiciels de retouche pour tracer l’origine d’une image. Sur un fichier généré par Claude (image, .png, .jpg, .svg), une petite note signée cryptographiquement est ajoutée aux métadonnées.
La différence avec le texte est fondamentale : rien dans le contenu du fichier ne change. C’est une étiquette externe. Elle est donc plus robuste qu’un filigrane textuel tant que les métadonnées sont préservées, mais elle disparaît dès qu’on retire les métadonnées, par exemple via une capture d’écran ou une conversion de format qui ne les conserve pas.
Pourquoi Anthropic marque ses contenus : l’EU AI Act
Le marquage répond aux obligations de transparence sur les contenus générés par IA, portées par l’EU AI Act et son code de bonnes pratiques.
En juillet 2026, Anthropic a signé le code de conduite européen sur la transparence des contenus générés par IA, aux côtés d’environ 190 signataires. Ce cadre impose de rendre les contenus IA identifiables par des moyens techniques. Anthropic a choisi d’appliquer le marquage mondialement, et non aux seuls utilisateurs européens, pour des raisons de cohérence opérationnelle.
Les modèles antérieurs au 2 août 2026 bénéficient d’une période de transition : le filigrane leur sera déployé progressivement dans les mois suivants. Ce cadre réglementaire s’ajoute à d’autres mesures récentes d’Anthropic, comme la vérification d’identité par pièce et biométrie introduite en juillet 2026 pour certains comptes.
Le filigrane survit-il au copier-coller et à l’édition ?
Oui pour le copier-coller, oui pour une édition légère, non pour une réécriture complète.
Puisque le signal est intégré au choix des mots eux-mêmes, il voyage avec le texte quand vous le copiez et le collez. Une édition légère ne suffit généralement pas à l’effacer complètement. En revanche, plusieurs transformations affaiblissent ou détruisent la détection.
| Transformation | Effet sur le filigrane |
|---|---|
| Copier-coller | Le filigrane reste intact |
| Édition légère (quelques mots) | Généralement conservé |
| Réécriture complète mot à mot | Effacé |
| Paraphrase poussée | Fortement affaibli à effacé |
| Traduction | Partiellement conservé (chaque mot est encore choisi par Claude), puis affaibli |
| Extraction d’un très court passage | Détection peu fiable |
| Combinaison avec d’autres textes | Signal dilué |
| Capture d’écran / conversion de format | Métadonnées C2PA perdues |
Anthropic est transparent sur ces limites : le filigrane est une aide à la traçabilité, pas une preuve infaillible. Sur un extrait de deux phrases, la détection n’est tout simplement pas fiable.
Comment détecter un texte marqué par Claude
Le seul détecteur fiable du filigrane SynthID-Text est celui d’Anthropic, qui n’est pas encore ouvert au public au 24 août 2026.
Anthropic a annoncé une API de détection, sans en communiquer la date de disponibilité ni les conditions d’accès. Tant qu’elle n’est pas ouverte, aucune vérification indépendante du filigrane n’est possible. C’est une limite importante à garder en tête : l’existence du marquage ne signifie pas que n’importe qui peut le lire.
Attention à ne pas confondre deux familles d’outils :
- Le détecteur SynthID-Text lit le filigrane cryptographique en analysant la séquence de jetons avec la clé. Fiable, mais réservé à Anthropic pour l’instant.
- Les détecteurs tiers (type Pangram) repèrent des « tics » stylistiques typiques de l’IA. Ils ne lisent pas le filigrane et exposent à des faux positifs, y compris sur des textes purement humains.
Si vous rédigez avec Claude puis retravaillez le texte, comprendre cette distinction est utile pour évaluer ce qui reste détectable. Pour situer Claude par rapport aux autres modèles sur les usages rédactionnels, notre comparatif Claude vs ChatGPT détaille les différences par cas d’usage.
Peut-on retirer le filigrane, et faut-il le faire ?
Techniquement, une réécriture intégrale efface le filigrane ; sur le plan éthique et contractuel, le retirer pour masquer l’origine IA est risqué.
Dès l’annonce d’Anthropic, des outils commerciaux ont promis de « nettoyer » le filigrane. Plusieurs points méritent d’être posés clairement.
D’abord, la seule méthode certaine reste la réécriture complète mot à mot. Anthropic le reconnaît : à ce stade, « on peut discuter de savoir si le texte peut encore être qualifié de généré par IA ». Autrement dit, effacer le filigrane revient à réécrire le contenu au point qu’il n’est plus vraiment de Claude.
Ensuite, les outils qui prétendent supprimer automatiquement le filigrane visent souvent les mauvais caractères. En testant plusieurs de ces « nettoyeurs » sur des sorties de Claude, j’ai constaté qu’ils s’attaquent surtout à des caractères Unicode invisibles, qui ne sont pas le mécanisme réel de SynthID-Text. Leur efficacité contre le filigrane statistique n’est pas vérifiable publiquement, puisque le détecteur officiel n’est pas accessible.
Enfin, la question éthique. Le filigrane ne vous empêche pas d’utiliser Claude, ni de publier vos contenus. Il documente une provenance. Chercher à le retirer pour faire passer un texte IA pour un texte humain peut violer les règles d’un employeur, d’une plateforme, d’un jury académique ou d’un client. Mon avis : dans la plupart des contextes professionnels, mieux vaut assumer l’usage de l’IA et retravailler le fond que de courir après l’effacement d’un signal.
Ce que ça change pour vous
Pour la grande majorité des utilisateurs, le filigrane est invisible et sans conséquence pratique au quotidien.
Pour les particuliers
Le marquage ne modifie ni l’expérience, ni la qualité, ni le coût. Vos conversations ne deviennent pas identifiables : le filigrane ne contient aucune donnée personnelle et ne remonte ni à vous, ni à une conversation précise. Si vous débutez avec l’outil, notre guide Claude pour débutants reste le point de départ le plus complet.
Le seul contexte sensible concerne les travaux où l’origine IA doit être déclarée (devoirs, publications soumises à charte). Là, le filigrane augmente le risque qu’un contenu non déclaré soit un jour identifiable, une fois le détecteur ouvert.
Pour les entreprises
L’enjeu est double. Côté conformité, le marquage aide à respecter les obligations de transparence de l’EU AI Act, ce qui est plutôt un atout pour les organisations soumises à ce cadre. Côté propriété et fuite d’information, il faut intégrer que les contenus produits en interne avec Claude portent une trace de provenance, y compris via l’API et les intégrations.
Au 24 août 2026, Anthropic n’a pas communiqué de mécanisme d’exemption pour les usages API ou entreprise : le marquage s’applique par défaut à tous les canaux. Les équipes qui produisent des livrables clients à partir de Claude ont donc intérêt à clarifier en amont leur politique d’usage de l’IA.
Mon verdict
Le filigrane Claude est une avancée de transparence honnête dans ses limites, mais qu’il ne faut pas surinterpréter. Il prouve qu’un texte est passé par Claude, pas qui l’a écrit, ni dans quel but. Sa fiabilité dépend fortement de la longueur et de la nature du contenu, et son détecteur n’est pas encore public.
Ce qu’il faut retenir : ne comptez pas sur des outils de « suppression » dont l’efficacité est invérifiable, et ne traitez pas le filigrane comme une preuve absolue. Après avoir suivi le dossier depuis la première annonce, je recommande une posture simple : pour la plupart des usages, la transparence sur l’emploi de l’IA vaut mieux que la course à l’effacement. La vraie question à surveiller dans les mois à venir n’est pas comment retirer le filigrane, mais quand et comment Anthropic ouvrira son API de détection.