Claude API : le guide de la Developer Platform (2026)
Claude API en 2026 : créer une clé dans la Console Anthropic, tester dans le Playground, choisir entre Fable 5.1, Opus 5.5 et Sonnet 5.5, premier appel.
La Claude API (ou Claude Developer Platform) est l’interface qui permet d’appeler les modèles d’Anthropic depuis votre propre code, via un seul point d’entrée : la Messages API. Pour démarrer, il vous faut un compte sur la Console Claude, une clé API et un SDK officiel (Python, TypeScript, Go, Java, C#, PHP ou Ruby) : le premier appel prend moins de dix minutes.
J’ai construit plusieurs intégrations sur cette API depuis 2024 et le parcours d’onboarding a beaucoup changé cette année. Le Workbench a laissé place au Playground le 18 août 2026, le SDK Python est passé en version 1.0 le 20 août puis 2.0 le 21 octobre, et la gamme de modèles a été renouvelée entre septembre et octobre avec Claude Fable 5.1, Opus 5.5, Sonnet 5.5 et Haiku 5.5. Voici le guide que j’aurais aimé avoir, mis à jour au 22 octobre 2026.
Ce qu’est la Claude Developer Platform
La Claude Developer Platform regroupe trois éléments : la Console Claude (platform.claude.com) pour gérer compte, clés et facturation ; la Messages API (POST /v1/messages) pour envoyer des requêtes aux modèles ; et les SDK officiels qui encapsulent cette API dans votre langage. Le Playground, les Batches, les Files et les Managed Agents sont des surfaces complémentaires qui s’appuient sur le même endpoint. Une CLI officielle, ant, permet aussi d’appeler l’API depuis le terminal (ant messages create).
Un point que beaucoup de débutants découvrent trop tard : le compte API est totalement indépendant de l’abonnement claude.ai. Un abonnement Pro ou Max ne donne aucun crédit API, et inversement. Si vous hésitez entre les deux approches, mon comparatif des abonnements Claude détaille quand le pay-as-you-go devient plus rentable.
L’ancienne adresse console.anthropic.com redirige vers platform.claude.com. Les deux désignent la même Console ; la documentation officielle vit désormais sur platform.claude.com/docs.
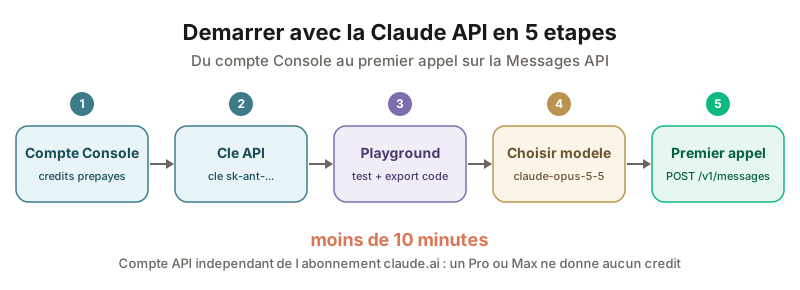 Du compte Console au premier appel à la Messages API : moins de dix minutes, avec un compte API indépendant de l’abonnement claude.ai.
Étape 1 : créer une clé API dans la Console Anthropic
Créer une clé API Claude prend deux minutes depuis la page platform.claude.com/settings/keys. La procédure officielle se déroule en quatre temps.
- Connectez-vous à la Console Claude sur platform.claude.com, ou créez un compte si vous n’en avez pas encore.
- Ouvrez la page API keys dans les paramètres de l’organisation.
- Cliquez sur Create key, nommez la clé, choisissez une date d’expiration (3 heures, 1 jour, 7 jours, 30 jours, durée personnalisée ou jamais) et un compte lié. Vous pouvez aussi restreindre la clé à un workspace précis : je vous le recommande, car une clé non rattachée à un workspace doit envoyer l’en-tête
anthropic-workspace-idsur chaque requête, faute de quoi l’API renvoie une erreur 400. - Copiez la clé immédiatement. Elle commence par
sk-ant-et n’est affichée qu’une seule fois. Perdue, elle est irrécupérable : il faudra en créer une nouvelle.
Les trois types de clés
La Console propose aujourd’hui trois types de clés. La clé personnelle agit en votre nom et cesse de fonctionner si vous quittez l’organisation. La clé de service account représente un compte technique, destiné aux pipelines CI, aux services en production ou aux agents.
La clé workspace, héritée de l’ancien système, n’a pas de propriétaire et survit au départ de son créateur. Anthropic la considère comme un format hérité et recommande de la remplacer par une clé identifiée ou par la fédération d’identité (Workload Identity Federation).
Ma recommandation : une clé personnelle pour le développement local, une clé de service account pour tout ce qui est partagé ou déployé. Les deux s’éteignent automatiquement quand le compte associé disparaît, ce qui évite les clés orphelines.
Facturation et limites de dépense
L’API fonctionne par crédits prépayés. Sans moyen de paiement et sans crédits, les requêtes échouent. Plusieurs guides tiers évoquent un crédit d’essai offert à l’ouverture du compte, mais je n’ai trouvé aucune confirmation dans la documentation officielle : je préfère vous dire que ce point n’est pas vérifié plutôt que de vous donner un chiffre.
Ce qui est documenté, en revanche, ce sont les plafonds mensuels par palier d’usage. Les organisations sont placées automatiquement dans un tier selon leur historique.
| Palier | Plafond de dépense mensuel | Requêtes/min sur Opus 5.5 | Tokens d’entrée/min |
|---|---|---|---|
| Evaluation (nouveaux comptes) | Inférieur aux paliers standard | Limites réduites | Limites réduites |
| Start | 500 $ | 1 000 | 2 000 000 |
| Build | 1 000 $ | 5 000 | 5 000 000 |
| Scale | 200 000 $ | 10 000 | 10 000 000 |
| Custom | Pas de plafond | Négocié | Négocié |
Un conseil que j’applique sur chaque nouveau projet : fixez votre propre limite de dépense dans la page Billing, en dessous du plafond du tier. Un script qui boucle sur un appel coûteux peut consommer plusieurs dizaines de dollars en quelques minutes.
Étape 2 : tester dans le Playground (ex-Workbench)
Le Playground est l’espace de test de la Console Claude. Il a remplacé le Workbench le 18 août 2026, au lendemain de la mise hors service de ce dernier. Sa particularité : il est construit directement sur la Messages API publique, ce qui signifie que la requête que vous testez est exactement celle que vous enverrez dans votre code.
Concrètement, le Playground permet de :
- saisir un message utilisateur et un prompt système, puis exécuter la requête et itérer ;
- changer de modèle et régler les paramètres comme
max_tokensou le niveau d’effort ; - ajouter des définitions d’outils et demander une sortie structurée, avec affichage des appels et résultats d’outils ;
- visualiser la requête et la réponse brutes, avec la raison d’arrêt (
stop_reason) et la consommation en tokens ; - charger des templates d’exemple, puis les modifier ;
- exporter la requête en un clic en Python ou TypeScript via le bouton « code ».
Les exemples de la documentation officielle peuvent aussi s’ouvrir directement dans le Playground. C’est, à mon avis, la fonctionnalité la plus utile pour un débutant : vous partez d’une requête qui fonctionne, vous la modifiez, vous exportez.
Ce que le Playground ne fait plus
Le Playground est sans état. Rien n’est stocké côté Anthropic : votre brouillon reste dans le navigateur et l’export de code est le seul moyen de conserver une requête. Les prompts enregistrés, l’historique, les évaluations et le partage du Workbench ont disparu, tout comme les endpoints generate_prompt, improve_prompt et templatize_prompt.
Si vous utilisiez le Workbench comme référentiel de prompts, la date limite d’export de vos données était fixée au 1er septembre 2026. Pour la suite, je vous conseille de versionner vos prompts dans votre dépôt Git, comme n’importe quel fichier de configuration. Les techniques décrites dans mon guide de prompt engineering pour Claude s’appliquent telles quelles dans le Playground.
Étape 3 : choisir un modèle et comprendre les tarifs
Anthropic recommande de commencer par Claude Opus 5.5 pour la majorité des cas d’usage, puis de passer à Claude Fable 5.1 uniquement si vos évaluations sur Opus 5.5 à effort élevé restent insuffisantes. Voici la gamme actuelle, d’après la page de tarifs officielle consultée le 22 octobre 2026.
| Modèle | ID API | Entrée / Sortie ($ par million de tokens) | Lecture cache | Effort par défaut | Sortie le |
|---|---|---|---|---|---|
| Claude Fable 5.1 | claude-fable-5-1 | 10 $ / 50 $ | 0,25 $ | high | 1er septembre 2026 |
| Claude Opus 5.5 | claude-opus-5-5 | 4 $ / 20 $ | 0,20 $ | medium | 22 septembre 2026 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | 2 $ / 10 $ | 0,10 $ | high | 28 septembre 2026 |
| Claude Haiku 5.5 | claude-haiku-5-5 | 0,10 $ / 0,50 $ (prompts ≤ 100 k tokens, 0,50 $ / 2,50 $ au-delà) | 0,01 $ | medium | 7 octobre 2026 |
| Claude Opus 5 (toujours disponible) | claude-opus-5 | 5 $ / 25 $ | 0,50 $ | high | 24 juillet 2026 |
| Claude Sonnet 5 (toujours disponible) | claude-sonnet-5 | 2 $ / 10 $ | 0,20 $ | high | 30 juin 2026 |
Tous les modèles de la gamme actuelle offrent une fenêtre de contexte de 1 million de tokens (environ 555 000 mots avec le tokenizer actuel, d’après la documentation des modèles) et jusqu’à 128 k tokens en sortie. Les ID sont des snapshots figés : claude-opus-5-5 désigne toujours la même version, sans suffixe de date à ajouter.
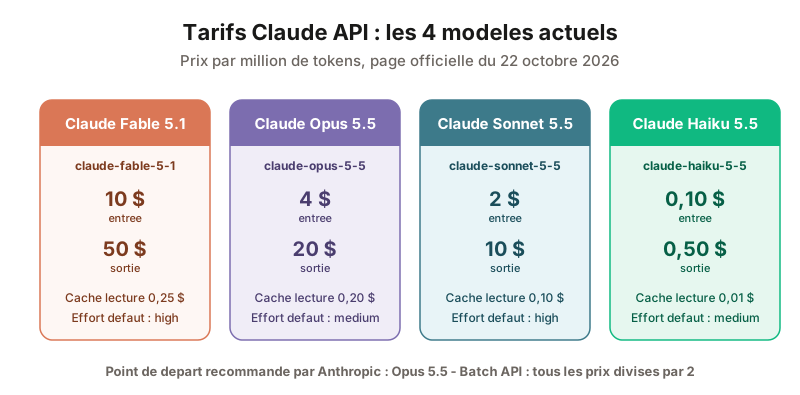 Les quatre modèles de la gamme actuelle : un écart de 1 à 100 entre Haiku 5.5 et Fable 5.1 en sortie, et le Batch API divise tous ces prix par deux.
Trois chiffres à retenir sur les coûts
Trois mécanismes pèsent lourd sur la facture, et je les vois trop souvent ignorés dans les premiers projets.
Premièrement, le Batch API divise le prix par deux (entrée et sortie) pour tout traitement qui peut attendre jusqu’à 24 heures. Deuxièmement, le prompt caching facture les lectures de cache à 10 % du prix d’entrée sur la plupart des modèles, 5 % sur Opus 5.5 et Sonnet 5.5, et 2,5 % sur Fable 5.1. Troisièmement, le tokenizer introduit avec Opus 4.7 produit environ 30 % de tokens en plus pour le même texte que les modèles antérieurs : comparez les prix à usage réel, pas par token.
Sur Opus 5.5, l’effort par défaut est medium, un cran en dessous des autres modèles. C’est un choix délibéré d’Anthropic pour contenir les coûts, mais pensez à le fixer explicitement si votre tâche demande du raisonnement approfondi. Les cinq niveaux sont détaillés dans mon article sur l’Effort Control de Claude.
Opus 5 et Sonnet 5 : faut-il migrer ?
Si vous avez démarré sur Opus 5 ou Sonnet 5 cet été, les deux modèles restent servis, avec un statut « legacy » dans la documentation. Opus 5.5 coûte pourtant 20 % de moins qu’Opus 5 (4 $ contre 5 $ en entrée) et ses lectures de cache sont facturées 0,20 $ au lieu de 0,50 $.
Attention toutefois : la migration implique des changements cassants (thinking impossible à désactiver, tool_choice forcé refusé, blocs de thinking liés au modèle). Pour un projet neuf, partez directement sur la génération 5.5. Mon comparatif Opus vs Sonnet vous aide à trancher entre les deux lignes.
Étape 4 : votre premier appel à la Messages API
Le premier appel tient en une dizaine de lignes. Toutes les requêtes passent par le même endpoint, quel que soit le modèle ou la fonctionnalité utilisée.
Avec cURL
export ANTHROPIC_API_KEY="sk-ant-..."

curl https://api.anthropic.com/v1/messages \
  -H "content-type: application/json" \
  -H "x-api-key: $ANTHROPIC_API_KEY" \
  -H "anthropic-version: 2026-10-21" \
  -d '{
    "model": "claude-opus-5-5",
    "max_tokens": 1000,
    "messages": [
      {"role": "user", "content": "Explique le prompt caching en trois phrases."}
    ]
  }'
L’en-tête x-api-key reste accepté, mais la documentation d’authentification présente désormais Authorization: Bearer $ANTHROPIC_API_KEY comme la forme de référence. La réponse JSON contient un tableau content avec des blocs typés (ici un bloc text), un stop_reason (end_turn si Claude a terminé naturellement) et un objet usage avec les tokens consommés. C’est cet objet usage que j’utilise pour suivre les coûts appel par appel.
Avec le SDK Python 2.x
python3 -m venv .venv && source .venv/bin/activate
pip install "anthropic>=2,<3"import anthropic
client = anthropic.Anthropic() # lit ANTHROPIC_API_KEY automatiquement
message = client.messages.create(
model="claude-opus-5-5",
max_tokens=1000,
output_config={"effort": "high"},
messages=[
{"role": "user", "content": "Explique le prompt caching en trois phrases."}
],
)
for block in message.content:
if block.type == "text":
print(block.text)Avec le SDK TypeScript
import Anthropic from "@anthropic-ai/sdk";

const client = new Anthropic();

const message = await client.messages.create({
  model: "claude-opus-5-5",
  max_tokens: 1000,
  messages: [
    { role: "user", content: "Explique le prompt caching en trois phrases." },
  ],
});

for (const block of message.content) {
  if (block.type === "text") console.log(block.text);
}
Deux habitudes à prendre dès le premier appel. Parcourez toujours content en filtrant sur block.type : les modèles actuels renvoient aussi des blocs thinking ou tool_use, et content[0] n’est pas forcément du texte. Et vérifiez stop_reason avant de lire la réponse : max_tokens signifie que la sortie a été tronquée, refusal qu’un classifieur de sécurité a décliné la requête.
Ce qui change avec les SDK Python 1.0 et 2.0
Le SDK Python anthropic est passé en version 1.0 le 20 août 2026, puis en version 2.0.0 le 21 octobre 2026. Les changements de la 1.0 sont limités mais concrets :
- Python 3.10 minimum (3.9 reste sur la dernière version 0.x) ;
- la couche HTTP passe de
httpxàhttpx2: les objetshttpx.Timeoutouhttpx.Clientpassés au SDK doivent venir dehttpx2; - les paramètres
temperature,top_pettop_ksont retirés des méthodes Messages ; - l’ancienne API Text Completions disparaît ;
output_formatdevientoutput_config={"format": {...}}pour les sorties structurées.
La version 2.0.0 envoie par défaut la version d’API 2026-10-21, transmet la clé dans l’en-tête Authorization: Bearer et retire le paramètre betas des méthodes Models non bêta. Les autres SDK ont suivi le même jour : TypeScript 1.0.0, Go 2.0.0 (chemin de module /v2), Java 3.0.0, C# 13.0.0, PHP 1.0.0, Ruby 2.0.0 et la CLI ant 2.0.0.
Ce retrait des paramètres d’échantillonnage n’est pas qu’un choix du SDK. La version d’API 2026-10-21, publiée le 21 octobre 2026, renvoie une erreur 400 sur toute requête Messages contenant temperature, top_p ou top_k, même à leur valeur par défaut et quel que soit le modèle. Si vous migrez du code écrit pour Sonnet 4.6, c’est le premier point à vérifier.
Deux nouveautés en bêta à connaître
Les deux fonctionnalités suivantes sont arrivées cet été et répondent à un même problème : modifier une conversation en cours sans invalider le cache de prompt, donc sans refacturer tout le préfixe. Elles sont en bêta et nécessitent un en-tête anthropic-beta explicite.
Mid-conversation tool changes
Jusqu’ici, la liste tools était figée pour la durée d’une conversation : toute modification réinitialisait le cache. Avec l’en-tête mid-conversation-tool-changes-2026-07-01, vous déclarez tous vos outils dès le départ avec defer_loading: true sur ceux qui doivent rester cachés, puis vous les activez ou retirez entre deux tours via un message de rôle system :
messages = [
    {"role": "user", "content": "Quelle est la météo prévue à Lyon demain ?"},
    {"role": "system", "content": [
        {"type": "tool_addition",
         "tool": {"type": "tool_reference", "name": "get_forecast"}},
    ]},
]
Un bloc tool_removal fait l’opération inverse. Pour modifier la définition d’un outil, l’en-tête plus récent inline-tools-2026-09-15 (bêta depuis le 22 septembre 2026, Claude API uniquement) permet d’envoyer la nouvelle définition complète dans un tool_addition de type tool_definition, sans toucher à tools ni invalider le cache. Avec l’en-tête mid-conversation-tool-changes-2026-07-01 seul, il faut retirer l’outil sur une requête, puis renvoyer la nouvelle définition dans tools sur la suivante.
Si vous branchez des serveurs MCP sur vos agents, cette mécanique se combine bien avec le chargement différé d’outils décrit dans mon guide Claude MCP.
Per-message effort
Avec l’en-tête mid-conversation-output-config-2026-07-01, un message system au contenu vide et portant output_config change le niveau d’effort à partir de ce point de la conversation, sans toucher au cache :
{"role": "system", "content": [], "output_config": {"effort": "low"}}Le cas d’usage typique est une boucle agentique qui alterne étapes difficiles (planification, débogage) et étapes routinières (renommer un fichier, formater une sortie). Le nouveau niveau s’applique à partir du prochain tour utilisateur contenant une vraie saisie : un message qui ne contient que des tool_result ne compte pas.
La fonctionnalité est disponible sur Fable 5.1, Opus 5.5, Opus 5, Sonnet 5.5 et Haiku 5.5, sur la Claude API et Google Cloud (et sur Amazon Bedrock pour Fable 5.1 et Opus 5.5 uniquement). Changer l’effort au niveau de la requête, lui, continue d’invalider le cache ; sur Fable 5.1, Anthropic précise en plus que le modèle suit moins bien un changement global, car ses réponses précédentes ont été écrites à l’ancien niveau.
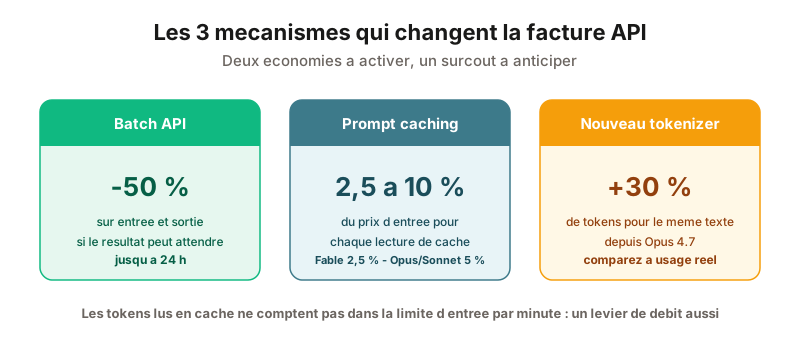 Deux économies à activer dès le premier projet (Batch, caching) et un surcoût à anticiper (tokenizer) : comparez les prix à usage réel, pas par token.
Bonnes pratiques pour un premier projet en production
Après plusieurs intégrations, voici les cinq règles que j’applique systématiquement et qui évitent l’essentiel des mauvaises surprises.
- Une clé par environnement, avec expiration. Développement, staging, production : trois clés distinctes, révocables indépendamment.
- Le streaming dès que la réponse peut être longue. Les SDK exigent le mode
stream()pour les grandes valeurs demax_tokens, faute de quoi vous heurtez le timeout HTTP de 10 minutes. - Le prompt caching sur tout contenu stable. Prompt système, définitions d’outils, documents de référence : placez-les en tête de requête avec
cache_controlet vérifiezusage.cache_read_input_tokenssur les appels suivants. Un zéro persistant signale un contenu volatil (horodatage, identifiant) qui casse le préfixe. - Le Batch API pour tout ce qui n’est pas interactif. Résumés nocturnes, classification de masse, enrichissement de données : 50 % d’économie immédiate.
- Un typage des erreurs, pas du string matching. Les SDK exposent
RateLimitError,AuthenticationError,BadRequestError: distinguez les erreurs réessayables (429, 5xx) de celles qui ne le sont pas (400, 404).
Un dernier point sur les rate limits : seuls les tokens non mis en cache comptent dans la limite d’entrée par minute. Avec 2 millions de tokens d’entrée par minute au palier Start et un taux de cache de 80 %, vous traitez effectivement 10 millions de tokens par minute. Le caching réduit donc la facture et multiplie aussi votre débit.
Mon verdict
La Claude API est aujourd’hui l’une des plateformes LLM les plus simples à prendre en main pour un développeur francophone : un endpoint unique, des SDK homogènes dans sept langages et un Playground qui exporte du code exécutable. La barrière d’entrée n’est plus technique, elle est budgétaire : comprenez le prompt caching, le Batch API et le paramètre d’effort avant de lancer le moindre script en boucle.
Mon conseil pour un premier projet : commencez sur Opus 5.5 dans le Playground, exportez la requête en Python, fixez une limite de dépense à 20 $ et mesurez usage sur chaque appel pendant une semaine. Vous saurez alors précisément quel modèle et quel niveau d’effort justifient leur prix pour votre cas d’usage ; si Opus 5.5 à effort élevé plafonne, mon guide de la gamme Fable 5 détaille ce que le modèle haut de gamme apporte réellement. Pour aller plus loin, la documentation officielle sur platform.claude.com/docs reste la référence, et je mettrai cet article à jour à chaque changement de gamme ou de tarif.