Claude Fable 5.1 et Mythos 5.1 : le guide complet
Claude Fable 5.1 et Mythos 5.1 : benchmarks (81,2 % SWE-bench Pro, 55,8 % Terminal-Bench 4.0), prix et cache à 0,25 $, écart avec Opus 5, accès et historique.
Claude Fable 5.1 est, depuis le 1er septembre 2026, le modèle le plus capable d’Anthropic en accès général : 81,2 % sur SWE-bench Pro, 55,8 % sur Terminal-Bench 4.0, 31,4 % sur AutomationBench, et un prix inchangé par rapport à Fable 5 (10 $ / 50 $ par million de tokens) avec des lectures de cache 75 % moins chères. Fable 5.1 et Claude Mythos 5.1 sont le même modèle : la seule différence tient aux garde-fous, actifs pour le grand public, assouplis pour les organisations vérifiées.
J’ai suivi cette gamme depuis le lancement de Fable 5 le 9 juin 2026, un lancement qui a connu un rebondissement rare : trois jours après sa sortie, le gouvernement américain a ordonné sa suspension au titre du contrôle des exportations, avant de la lever fin juin. Je fais ici le point, mis à jour, sur ce qu’apporte Fable 5.1, ses benchmarks face à Fable 5 et Opus 5, son prix, qui peut accéder à Mythos 5.1, et l’historique de juin qui a fait de Fable le premier modèle frontière commercialisé « sous autorisation ».
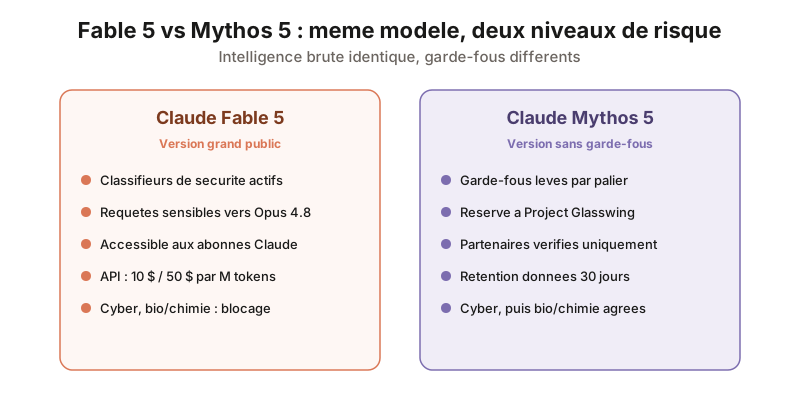 Fable et Mythos partagent le même socle : seuls les garde-fous et le public autorisé changent. La logique est inchangée entre la version 5 et la version 5.1.
Fable 5.1 ou Mythos 5.1 : la différence n’est pas la puissance
Fable 5.1 et Mythos 5.1 partagent le même modèle sous-jacent. L’intelligence brute est identique ; la distinction porte sur les garde-fous, les domaines accessibles et le public autorisé. Anthropic l’écrit sans détour dans son annonce : « Claude Fable 5.1 et Claude Mythos 5.1 sont le même modèle, mais avec des niveaux de garde-fous différents. »
Cette approche, inaugurée avec Fable 5 en juin, installe une logique de commercialisation de l’IA frontière par niveaux de risque et non plus seulement par niveaux de puissance (Haiku, Sonnet, Opus). Anthropic reconnaît ainsi qu’un modèle suffisamment compétent en cybersécurité présente des capacités offensives parallèles à ses bénéfices défensifs.
Fable 5.1 : la version grand public avec classifieurs
Fable 5.1 intègre des classifieurs qui détectent les requêtes sensibles et les réorientent vers un modèle moins capable. Ces classifieurs couvrent :
- Cybersécurité offensive : les requêtes signalées basculent sur Claude Opus 4.8. Fable 5.1 peut désormais servir à découvrir des vulnérabilités logicielles, mais pas à développer des exploits.
- Biologie et chimie : les requêtes signalées basculent sur Claude Opus 5.
- Distillation : tentatives d’extraction des capacités du modèle. Les nouveaux comptes API ne peuvent plus modifier manuellement un contexte antérieur tout en conservant le raisonnement produit par Claude.
Le changement le plus concret par rapport à Fable 5 concerne la précision de ces garde-fous. Anthropic indique que les nouveaux classifieurs cyber bloquent 60 % de faux positifs en moins, et que les utilisateurs de Claude Code constatent en moyenne environ 60 % d’interventions en moins par session.
Côté biologie, les classifieurs se déclenchent 85 % moins souvent sur les questions bénignes de biologie élémentaire et de médecine. Dans l’assistant claude.ai, une requête détectée est traitée par le modèle de repli sans intervention de votre part ; dans l’API, elle est bloquée sauf si vous configurez le repli (fallback), et les requêtes redirigées ne sont pas facturées au tarif Fable.
Mythos 5.1 : la version sans laisse, réservée aux organisations vérifiées
Mythos 5.1 est la même architecture, mais avec les garde-fous assouplis pour des organisations vérifiées. Il est déployé avec « les mêmes garde-fous que ceux appliqués à Mythos 5 » et Anthropic le décrit comme le modèle aux capacités cyber les plus élevées qu’elle ait jamais publié, tout en le classant dans la catégorie de risque la plus basse de son Frontier Compliance Framework.
L’accès passe par deux programmes :
- Cyber Verification Program (CVP) : pour les équipes de sécurité défensive. Les candidatures se font une fois par organisation via le Verification Portal, avec une réponse annoncée sous sept jours ouvrés. Les membres de Project Glasswing, le programme qui réunissait les partenaires de Mythos 5, n’ont pas à refaire de demande.
- Life Sciences Verification Program (LSVP) : pour les chercheurs en sciences du vivant, un programme développé en partenariat avec le gouvernement américain. Les premiers participants sont enrôlés depuis septembre.
Au 22 octobre 2026, Mythos 5.1 n’est « disponible que pour un ensemble d’organisations américaines ». Anthropic indique coordonner avec le gouvernement américain l’élargissement de l’accès à des partenaires nationaux et internationaux. Les modèles Fable et Mythos imposent par ailleurs une rétention des données de 30 jours pour le monitoring de sécurité ; les clients Enterprise éligibles peuvent obtenir une rétention nulle en attendant le déploiement des Enterprise Frontier Safeguards, qui stockent les données dans une infrastructure cloud contrôlée par le client.
Pour situer ce palier dans l’histoire récente d’Anthropic, notre analyse de Claude Mythos revient sur la fuite d’avril 2026 qui avait révélé l’existence du modèle avant son lancement officiel. L’article que vous lisez traite, lui, du lancement commercial de juin et de sa mise à jour de septembre.
Les benchmarks de Claude Fable 5.1
Fable 5.1 progresse sur toutes les catégories de benchmarks publiées par Anthropic et dépasse Opus 5 sur chacune d’elles. Le gain le plus net porte sur la recherche scientifique agentique : 52,6 % sur Terminal-Bench-Science 0.1, contre 24,7 % pour Fable 5 et 29,0 % pour Opus 5. Sur le codage en terminal (Terminal-Bench 4.0), il gagne près de 14 points sur Fable 5.
Le tableau ci-dessous compare Fable 5.1 à son prédécesseur direct et à Opus 5, le modèle qu’il surclasse désormais sur l’ensemble des épreuves. Les scores proviennent de l’annonce d’Anthropic, à l’exception du score SWE-bench Pro.
| Benchmark | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 |
|---|---|---|---|
| SWE-bench Pro | 81,2 % | 80,3 % | 79,2 % |
| Terminal-Bench 4.0 | 55,8 % | 42,0 % | 52,3 % |
| Terminal-Bench-Science 0.1 | 52,6 % | 24,7 % | 29,0 % |
| AutomationBench | 31,4 % | 17,1 % | 26,9 % |
| CursorBench 3.2.0 | 73,4 % | 70,5 % | 70,0 % |
| OSWorld 2.0 (strict) | 41,7 % | 36,1 % | 39,6 % |
| Humanity’s Last Exam (avec outils) | 65,0 % | 63,8 % | 63,6 % |
| GDPval-AA v2 (Elo) | 1853 | 1723 | 1824 |
Trois précisions de lecture. Sur Terminal-Bench 4.0, Mythos 5.1 atteint 60,9 % contre 55,8 % pour Fable 5.1 : l’écart de cinq points correspond, d’après Anthropic, aux tâches sur lesquelles les anciens classifieurs cyber intervenaient. Sur OSWorld 2.0 et AutomationBench, Fable 5.1 et Fable 5 ont obtenu zéro sur les tâches où les garde-fous se sont déclenchés, ce qui pénalise mécaniquement leurs scores. Enfin, l’erreur standard sur Terminal-Bench-Science est de l’ordre de ±3,5 à 4,5 points par modèle.
Au-delà des chiffres, plusieurs retours terrain illustrent le saut. Sur le benchmark d’agent de navigation de Browserbase, Fable 5.1 obtient 82 % contre 74 % pour Opus 5 et 57 % pour Fable 5. Shopify rapporte un score RedlineBench passé de 47,9 à 57,0 par rapport à Fable 5, et Cognition indique avoir basculé son trafic Opus 5 vers Fable 5.1 à coût par tâche inférieur.
Côté science, Mythos 5.1 a conçu des liants protéiques avec un taux de réussite proche de 50 % sur 12 cibles, là où les méthodes habituelles plafonnent entre 10 et 15 %.
Rappel : les scores de Fable 5 au lancement de juin 2026
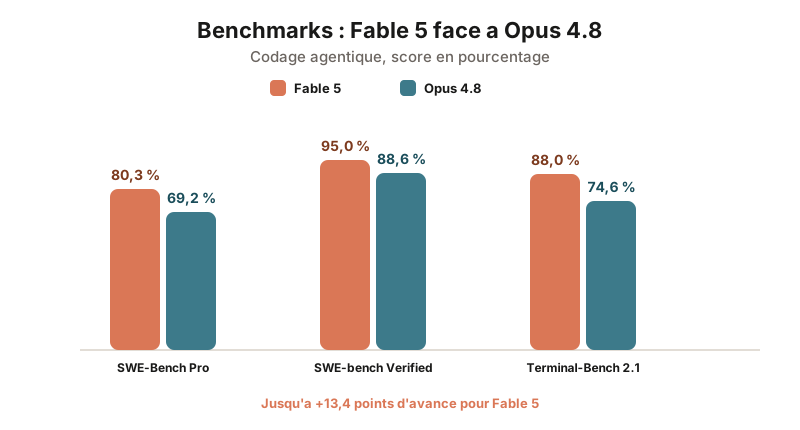 Au lancement de juin, Fable 5 devançait Opus 4.8 de 11 points sur SWE-Bench Pro et de plus de 13 points sur Terminal-Bench 2.1.
Pour mémoire, Fable 5 affichait déjà l’état de l’art à sa sortie du 9 juin 2026. Le tableau ci-dessous reprend la comparaison publiée à l’époque face à Opus 4.8 et aux concurrents du moment.
| Benchmark | Claude Fable 5 | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| SWE-Bench Pro | 80,3 % | 69,2 % | 58,6 % | 54,2 % |
| SWE-bench Verified | 95,0 % | 88,6 % | - | - |
| Terminal-Bench 2.1 | 88,0 % | 74,6 % | 83,4 % | 70,7 % |
| FrontierCode Diamond | 29,3 % | 13,4 % | - | - |
| GDPval-AA (Elo) | 1932 | 1890 | - | - |
| Humanity’s Last Exam | 59 / 64,5 % | - | - | - |
Stripe avait alors rapporté que Fable 5 avait compressé « des mois d’ingénierie en quelques jours » : une migration Ruby de 50 millions de lignes bouclée en une journée, contre deux mois en manuel. Les versions de benchmarks ont changé depuis (Terminal-Bench 2.1 puis 4.0, GDPval-AA puis v2), ce qui explique que les deux tableaux ne soient pas directement comparables ligne à ligne.
Comme tout modèle de ce palier, Fable 5.1 conserve une fenêtre de contexte de 1 million de tokens et un maximum de 128 k tokens en sortie. Le raisonnement adaptatif (adaptive thinking) est toujours actif : vous ne le désactivez pas, vous réglez sa profondeur avec le paramètre d’effort, du niveau low au niveau max, avec high par défaut dans l’API et Claude Code et medium dans claude.ai et Claude Cowork.
Prix et disponibilité de Fable 5.1
Fable 5.1 est facturé 10 $ par million de tokens en entrée et 50 $ par million en sortie, un tarif identique à Fable 5 et double de celui d’Opus 5 (5 $ / 25 $). C’est en revanche moins de la moitié du tarif de Mythos Preview, qui était fixé à 25 $ / 125 $ lors de son annonce officielle du 7 avril 2026.
| Poste (par million de tokens) | Claude Fable 5.1 | Claude Fable 5 | Claude Opus 5 |
|---|---|---|---|
| Entrée | 10 $ | 10 $ | 5 $ |
| Sortie | 50 $ | 50 $ | 25 $ |
| Lecture de cache | 0,25 $ | 1 $ | 0,50 $ |
| Écriture de cache (5 min) | 12,50 $ | 12,50 $ | 6,25 $ |
| Batch API (entrée / sortie) | 5 $ / 25 $ | 5 $ / 25 $ | 2,50 $ / 12,50 $ |
Tarification API et consommation de crédits
L’identifiant de modèle dans l’API est claude-fable-5-1. La vraie nouveauté tarifaire est le prix des lectures de cache : 0,25 $ par million de tokens, soit 2,5 % du prix d’entrée, contre 1 $ sur Fable 5. Cette baisse de 75 % change l’économie des workflows qui réinjectent un contexte stable à chaque appel, typiquement les agents et le RAG.
Anthropic estime la facture globale environ 25 % plus basse que sur Fable 5 pour une charge classique, et jusqu’à environ 45 % sur les usages fortement agentiques.
Deuxième source d’économie : l’efficacité à effort réduit. À effort low ou medium, Fable 5.1 égale ou dépasse Fable 5 tout en consommant moins de tokens. Le prix de sortie reste néanmoins le double de celui d’Opus 5, et deux fois et demie celui d’Opus 5.5 (4 $ / 20 $) : pour la plupart des tâches de codage courantes, un Opus reste le meilleur rapport performance/coût, et Anthropic elle-même recommande de démarrer sur Opus 5.5 avant de passer à Fable 5.1 si vos évaluations à effort élevé restent insuffisantes.
Un dernier point de facturation : l’inférence restreinte aux États-Unis (inference_geo: "us") applique un coefficient de 1,1 sur tous les postes.
Pour créer votre clé, tester le modèle dans le Playground et configurer le repli sur refus, notre guide de la Claude API détaille la mise en route pas à pas. Si vous gérez plusieurs niveaux de modèles selon la complexité des requêtes, notre guide Opus 4.8 explique l’Effort Control et la logique de routage, et notre guide Opus 5 situe le palier Opus face à Fable.
Plateformes et abonnements
Fable 5.1 est disponible via la Claude API, Claude Platform on AWS, Amazon Bedrock (identifiant anthropic.claude-fable-5-1), Google Cloud Vertex AI et Microsoft Foundry. Côté claude.ai, il est inclus pour les abonnés Pro, Max, Team et Enterprise, ainsi que dans Claude Code. Sur les plans Max, Fable et Mythos 5.1 partagent une enveloppe commune plafonnée à 50 % de la limite hebdomadaire d’utilisation.
Ce fonctionnement simple contraste avec le calendrier d’accès prévu pour Fable 5 en juin 2026, que je reproduis ici pour mémoire :
| Période | Accès sur Pro / Max / Team / Enterprise |
|---|---|
| 9 – 22 juin 2026 | Inclus sans surcoût |
| À partir du 23 juin 2026 | Usage facturé sur crédits séparés |
| Ultérieurement | Réintégration aux plans selon capacité |
Ce calendrier explique pourquoi les recherches « Fable 5 22 juin » avaient explosé : c’était la date charnière de bascule vers un modèle payant à crédits. La suite des événements a toutefois rebattu les cartes.
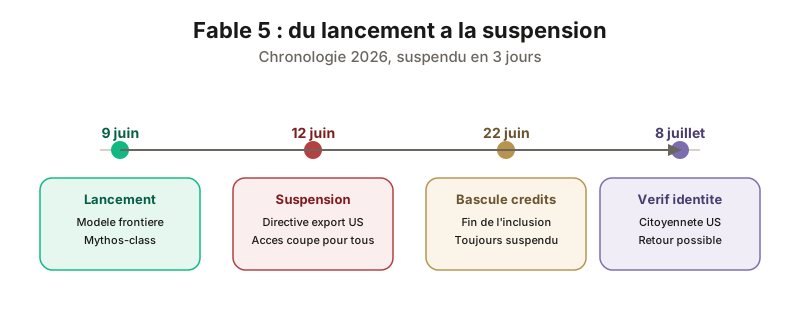 Suspendu trois jours après son lancement, Fable 5 a été rétabli le 1er juillet après la levée des contrôles à l’export du 30 juin.
La suspension du 12 juin : le « catch » de Fable 5
Trois jours après le lancement, le 12 juin 2026, Anthropic a suspendu tout accès à Fable 5 et Mythos 5. Le gouvernement américain, invoquant ses prérogatives de sécurité nationale, avait émis une directive de contrôle des exportations interdisant l’accès à ces deux modèles par tout ressortissant étranger, à l’intérieur comme à l’extérieur des États-Unis.
Dans son communiqué, Anthropic indiquait : « Le gouvernement américain, invoquant des autorités de sécurité nationale, a émis une directive de contrôle des exportations visant à suspendre tout accès à Fable 5 et Mythos 5 par tout ressortissant étranger. » L’entreprise précisait croire à un malentendu et travailler à rétablir l’accès au plus vite.
 La directive d’export a coupé l’accès à Fable 5 pour tous les ressortissants étrangers, du jour au lendemain.
La logique du « deemed export »
Le motif invoqué par Washington est une méthode présumée de contournement des classifieurs de Fable 5, qui aurait permis d’identifier des vulnérabilités logicielles. Après examen, Anthropic a estimé que la démonstration ne révélait qu’« un petit nombre de vulnérabilités mineures déjà connues ».
La difficulté technique tient au concept de deemed export. La conformité ne se limite pas aux connexions directes à la plateforme : une entreprise peut être tenue d’empêcher l’export du service via les appels d’API, les outils intégrés et les systèmes automatisés. Comme il était impossible de filtrer proprement par nationalité à l’échelle de l’API, Anthropic a coupé l’accès pour tout le monde.
Une onde de choc en Europe et en France
La décision a provoqué une réaction immédiate de ce côté de l’Atlantique. Le Conseil de l’intelligence artificielle et du numérique (CIANum) a dénoncé la matérialisation du risque de « kill switch » souvent évoqué. Pour lui, la dépendance aux modèles étrangers n’est plus une menace théorique mais « une réalité tangible ».
Dans la foulée, la France a annoncé une enveloppe supplémentaire de 655 millions d’euros pour l’IA dans le cadre de France 2030, afin de réduire sa dépendance aux technologies américaines après s’être fait « couper le robinet ». Pour les décideurs européens, l’épisode Fable 5 est devenu un cas d’école de souveraineté numérique.
Le statut au 22 juin et la vérification d’identité
Au 22 juin 2026, Fable 5 et Mythos 5 restaient suspendus pour les ressortissants étrangers. Le « catch » de cette date était double : c’était à la fois la fin de la période d’inclusion gratuite dans les abonnements et la fenêtre durant laquelle Anthropic espérait rétablir l’accès aux plans payants.
Une piste de sortie évoquée alors passait par la politique de vérification d’identité entrée en vigueur le 8 juillet 2026. En vérifiant la citoyenneté américaine de ses utilisateurs, Anthropic aurait pu restaurer Fable 5 pour le public américain sans attendre la levée complète de la directive. Les événements ont finalement été plus rapides : un premier déblocage est intervenu quatre jours plus tard, et la levée complète huit jours plus tard.
La levée partielle du 26 juin, puis le retour du 1er juillet
Le 26 juin 2026, après deux semaines de négociations quasi quotidiennes avec Anthropic, le gouvernement américain a partiellement assoupli sa directive. Le secrétaire au Commerce Howard Lutnick a adressé une lettre à Tom Brown, responsable du calcul chez Anthropic, l’autorisant à redéployer Mythos 5 auprès d’un groupe restreint d’organisations américaines. La formule employée est explicite : « J’ai déterminé que des garanties appropriées sont en place pour permettre à certains partenaires de confiance d’accéder au modèle Claude Mythos 5. »
Qui a retrouvé l’accès le 26 juin
L’autorisation visait environ une centaine d’entreprises et d’agences fédérales américaines, en priorité celles qui opèrent et défendent des infrastructures critiques, exactement le périmètre que Project Glasswing était censé servir. Point notable : au sein de ces organisations agréées, les employés non américains et le personnel international d’Anthropic lui-même retrouvaient le droit d’utiliser Mythos 5. La levée dérogeait donc, pour ce cercle restreint, à l’interdiction de principe qui frappait tout ressortissant étranger.
La décision ne concernait que Mythos 5. Elle était muette sur Fable 5, la version grand public avec classifieurs, qui restait inaccessible à cette date. Anthropic indiquait poursuivre les échanges avec le gouvernement pour rendre Fable 5 « de nouveau disponible pour un usage général ».
La levée complète du 30 juin et le retour de Fable 5
Le dénouement est arrivé quatre jours plus tard. Le 30 juin 2026, le Département du Commerce a levé les contrôles à l’export sur Fable 5 et Mythos 5, Anthropic ayant pris des engagements sur la gestion des risques de sécurité : accès du gouvernement aux modèles avant leur sortie, partage rapide d’informations sur les garde-fous et équipes de recherche dédiées à des standards de sécurité communs, d’après la synthèse de The Next Web.
Fable 5 est redevenu disponible dans le monde entier à partir du 1er juillet sur claude.ai, dans Claude Code et via l’API, puis sur les clouds partenaires. Anthropic a par ailleurs déployé un classifieur amélioré qui bloque la technique de contournement incriminée dans plus de 99 % des cas testés, selon ses propres chiffres.
Fable 5.1, sorti deux mois plus tard, n’a connu aucune restriction de ce type : il est en accès général sur toutes les plateformes depuis le 1er septembre. Seul Mythos 5.1 reste, pour l’heure, limité à des organisations américaines, mais par le jeu des programmes de vérification d’Anthropic, et non par une directive gouvernementale.
Faut-il s’intéresser à Fable 5.1 aujourd’hui ?
Mon avis : Fable 5.1 est le modèle le plus capable que vous puissiez utiliser sans vérification particulière, et son intérêt pratique ne dépend plus de votre géographie. Il dépend de deux variables : la difficulté réelle de vos tâches et votre budget.
 L’intérêt de Fable 5.1 se pèse entre sa puissance brute et votre budget ; la contrainte géographique de juin a disparu pour la version grand public.
Pour une équipe qui fait tourner des agents de longue durée, de la recherche scientifique assistée ou des refactorings de grande ampleur, Fable 5.1 est l’outil de référence : il dépasse Opus 5 sur toutes les catégories publiées, double quasiment le score de Fable 5 en investigation scientifique et, grâce au cache à 0,25 $, revient 25 à 45 % moins cher que Fable 5 à usage égal. Si vous étiez déjà sur Fable 5, la bascule se résume à changer l’identifiant de modèle, après avoir vérifié les changements cassants côté API (tool_choice forcé supprimé, blocs de raisonnement liés au modèle).
Pour un usage quotidien de codage ou d’automatisation, la bascule n’est pas urgente. Anthropic recommande elle-même de démarrer sur Opus 5.5, à 4 $ / 20 $, et de ne monter sur Fable 5.1 que si vos évaluations à effort élevé plafonnent. C’est aussi le palier Opus vers lequel Fable 5.1 réoriente ses propres requêtes sensibles, un signe que, pour la majorité des usages, l’écart pratique reste modéré.
Ce qu’il faut retenir : avec Fable, Anthropic vend pour la première fois ses modèles frontière par niveaux de risque. Au-delà des benchmarks, Fable 5 est le premier modèle dont l’histoire commerciale a été suspendue, partiellement rouverte, puis rétablie par décision de l’exécutif américain en l’espace de trois semaines. Fable 5.1 hérite de cette architecture à deux niveaux, Fable pour tous et Mythos pour les organisations vérifiées, mais dans un cadre désormais stabilisé : l’accès à l’IA la plus avancée se négocie organisation par organisation, sous le contrôle des programmes de vérification d’Anthropic plutôt que sous celui du contrôle des exportations.