Claude Opus 5 : tout savoir sur le nouveau flagship
Claude Opus 5 est le nouveau modèle flagship d’Anthropic, lancé le 24 juillet 2026. Il atteint une performance très proche de Fable 5 tout en coûtant deux fois moins cher — 5 $ par million de tokens en entrée et 25 $ en sortie, contre 10 $ / 50 $ pour Fable 5 — et devance à la fois Fable 5 et GPT-5.6 Sol sur Frontier-Bench avec un score de 43,3 %.
Concrètement, Opus 5 est la réponse d’Anthropic à une critique récurrente : la puissance de niveau frontière était jusqu’ici réservée à des modèles chers (Fable 5) ou géographiquement contraints (Mythos 5). Ce guide couvre les benchmarks, le nouveau toggle d’effort à trois niveaux, les garde-fous cybersécurité renforcés, le comparatif avec Opus 4.8 et Fable 5, ainsi que la migration. Les données proviennent de l’annonce officielle d’Anthropic et de la documentation technique du modèle.
Ce qui change avec Opus 5 : la performance frontière au prix d’Opus
Opus 5 est le premier modèle Anthropic à combiner trois propriétés jusqu’ici mutuellement exclusives : une performance proche du palier Mythos-class, le tarif standard d’Opus, et une disponibilité mondiale sans restriction d’export.
Rappelons la situation qui prévalait avant ce lancement. Fable 5, lancé le 9 juin 2026, offrait des scores de codage agentique supérieurs mais à un tarif double et avec une disponibilité grand public contrainte par une directive de contrôle des exportations américaine. Opus 4.8, lancé le 28 mai, restait le choix par défaut : moins cher, disponible partout, mais un cran en dessous sur les tâches les plus lourdes.
Opus 5 comble une grande partie de cet écart. Il apporte le niveau de capacité frontière à ceux qui étaient exclus de Fable 5 pour des raisons de prix ou de géographie.
| Modèle | Prix entrée / sortie | Contexte | Disponibilité |
|---|---|---|---|
| Opus 5 | 5 $ / 25 $ par MTok | 1M tokens | Mondiale, sans restriction |
| Fable 5 | 10 $ / 50 $ par MTok | 1M tokens | Grand public contrainte (export US) |
| Opus 4.8 | 5 $ / 25 $ par MTok | 1M tokens | Mondiale, sans restriction |
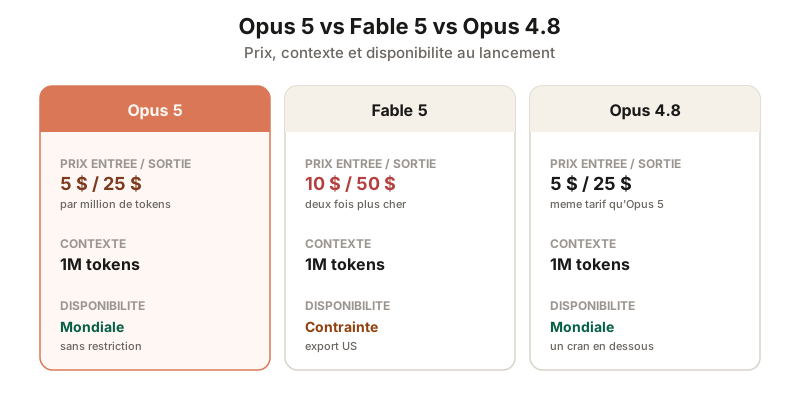 Opus 5 offre le tarif d’Opus 4.8 (5 $ / 25 $) avec une disponibilite mondiale, la ou Fable 5 coute deux fois plus cher et reste contraint a l’export US.
Benchmarks : Opus 5 devance Fable 5 et GPT-5.6 Sol sur Frontier-Bench
Opus 5 obtient 43,3 % sur Frontier-Bench, un score qui dépasse celui de Fable 5 (33,7 %) et de GPT-5.6 Sol (34,4 %), le modèle frontière d’OpenAI de cette génération. Frontier-Bench v0.1 mesure le codage agentique — un modèle qui résout des tâches d’ingénierie multi-étapes comme le ferait un agent autonome, noté au pourcentage de tâches réussies de bout en bout. Le score d’Opus 5 fait plus du double de celui d’Opus 4.8 (18,7 %), à un coût par tâche inférieur.
Le tableau ci-dessous situe Opus 5 face à ses deux prédécesseurs Anthropic et au concurrent principal.
| Benchmark | Opus 5 | Fable 5 | Opus 4.8 | GPT-5.6 Sol |
|---|---|---|---|---|
| Frontier-Bench (codage agentique) | 43,3 % | 33,7 % | 18,7 % | 34,4 % |
| ARC-AGI 3 (raisonnement abstrait) | 30,2 % | — | — | 7,8 % |
| SWE-Bench Pro (code) | 79,2 % | 80,0 % | 69,2 % | — |
| OSWorld 2.0 (computer use) | état de l’art | — | 83,4 %* | — |
Le score OSWorld cité pour Opus 4.8 (83,4 %) porte sur la version antérieure du benchmark (OSWorld-Verified). OSWorld 2.0 est plus difficile. Sur SWE-Bench Pro, la barre haute du secteur reste Mythos 5 (80,3 %) ; Opus 5 s’en approche à 79,2 %, juste derrière Fable 5 (80,0 %).
Trois enseignements ressortent de ces résultats.
Frontier-Bench est le nouveau juge de paix. En dépassant Fable 5 (33,7 %) et GPT-5.6 Sol (34,4 %) sur ce benchmark de codage agentique, Opus 5 démontre qu’il ne s’agit pas d’un simple modèle « milieu de gamme optimisé ». Sur les tâches d’ingénierie autonome de bout en bout, il est en tête à un tarif deux fois inférieur à celui de Fable 5.
Le computer use franchit un cap sur OSWorld 2.0. Anthropic revendique l’état de l’art sur cette nouvelle version du benchmark, réputée plus difficile que l’OSWorld-Verified utilisé pour Opus 4.8. Anthropic précise qu’Opus 5 atteint ce niveau à environ un tiers du coût des modèles concurrents comparables. Pour les cas d’usage de computer use — pilotage d’interfaces, automatisation d’écrans — c’est une avancée directement exploitable.
ARC-AGI 3 confirme le saut de raisonnement abstrait. Sur ce benchmark conçu pour résister à la mémorisation, Opus 5 obtient un score revendiqué à environ trois fois celui du modèle suivant. ARC-AGI mesure la capacité à généraliser sur des tâches inédites, un indicateur suivi de près par la communauté.
Sur les benchmarks de codage agentique historiques comme SWE-Bench Pro, Fable 5 conserve un léger avantage brut grâce à son socle Mythos-class : 80,0 % contre 79,2 % pour Opus 5, soit huit dixièmes de point d’écart. L’écart est désormais marginal, et Opus 5 le compense par son prix et sa disponibilité.
Le toggle low/medium/high : régler l’effort en trois niveaux
Opus 5 introduit un réglage d’effort simplifié à trois niveaux — low, medium et high — accessible via un sélecteur dans Claude.ai ou le paramètre effort de l’API. C’est une évolution du système à cinq niveaux qu’avait inauguré Opus 4.8.
| Niveau | Identifiant API | Usage recommandé |
|---|---|---|
| Low | low | Réponses rapides, sous-agents, tâches simples à fort volume, économie de tokens |
| Medium | medium | Tâches courantes nécessitant un équilibre performance/coût |
| High | high (défaut) | Raisonnement approfondi, problèmes complexes, codage agentique exigeant |
Le niveau high est le défaut. Anthropic l’a calibré pour offrir le meilleur équilibre entre profondeur de réponse et coût sur la majorité des cas d’usage.
Le niveau low est le levier d’économie. Il est particulièrement adapté aux sous-agents parallèles et aux requêtes répétitives : moins de tokens consommés, réponses plus rapides, préservation du rate limit. C’est le niveau à privilégier quand vous orchestrez des dizaines de sous-tâches simples.
Le niveau medium est le point d’entrée pour les workflows sensibles au coût. Il offre un compromis quand vous avez mesuré que high est surdimensionné pour la tâche.
Cette réduction de cinq à trois niveaux répond à un retour terrain que je partage : la distinction entre xhigh et max d’Opus 4.8 était difficile à arbitrer en pratique, et je basculais souvent de l’un à l’autre sans gain mesurable. Pour approfondir la logique de routage entre niveaux d’effort, notre guide de l’Effort Control détaille les arbitrages à appliquer selon le type de tâche.
Via l’API, le paramètre se passe dans output_config :
import anthropic
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-opus-5",
max_tokens=4096,
thinking={"type": "adaptive"},
output_config={"effort": "high"}, # low | medium | high
messages=[{"role": "user", "content": "Analyse cette architecture micro-services."}]
)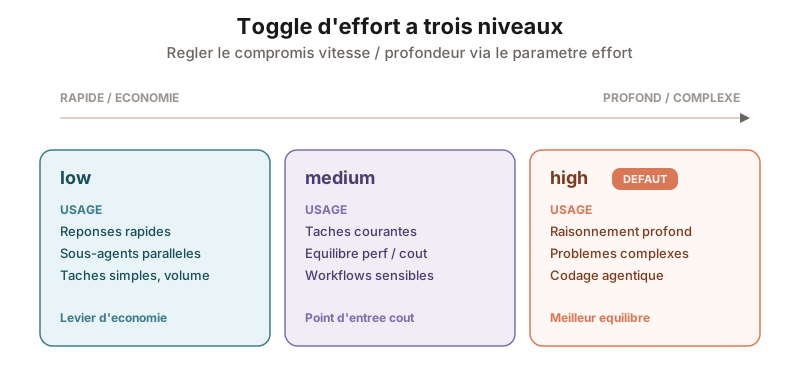 Le parametre effort remplace le systeme a cinq niveaux d’Opus 4.8 : low pour l’economie, medium pour l’equilibre, high (defaut) pour le raisonnement approfondi.
Garde-fous cybersécurité : le modèle le plus aligné d’Anthropic
Anthropic présente Opus 5 comme son modèle le plus aligné à ce jour, avec des garde-fous cybersécurité renforcés par rapport à Opus 4.8 et à la logique de classifieurs de Fable 5. Anthropic indique que les classifieurs interviennent environ 85 % moins souvent que sur Fable 5, ce qui réduit les faux positifs sur les usages légitimes.
La nouveauté la plus concrète tient à une distinction technique : Opus 5 peut analyser du code source pour assister la défense logicielle, mais il refuse d’analyser des binaires compilés. Cette frontière n’est pas arbitraire.
L’analyse de code source sert majoritairement la défense. Revue de code, détection de vulnérabilités dans un dépôt, audit de dépendances : ces usages reposent sur du code lisible et légitime, que les équipes de sécurité manipulent au quotidien.
L’analyse de binaires compilés est plus souvent associée à l’offensive. L’ingénierie inverse d’un exécutable dont on ne possède pas le code source correspond à un profil d’usage typique de l’exploitation de vulnérabilités. En refusant ce cas de figure, Opus 5 conserve son utilité défensive tout en réduisant sa surface offensive.
Cette approche prolonge la logique de commercialisation « par niveaux de risque » qu’Anthropic avait inaugurée avec le palier Mythos-class. Là où Fable 5 réorientait les requêtes sensibles vers un modèle plus contraint, Opus 5 intègre directement ces garde-fous dans un modèle unique disponible pour tous. Pour les enjeux de sécurité en contexte de développement, notre guide sécurité de Claude Code détaille les bonnes pratiques complémentaires.
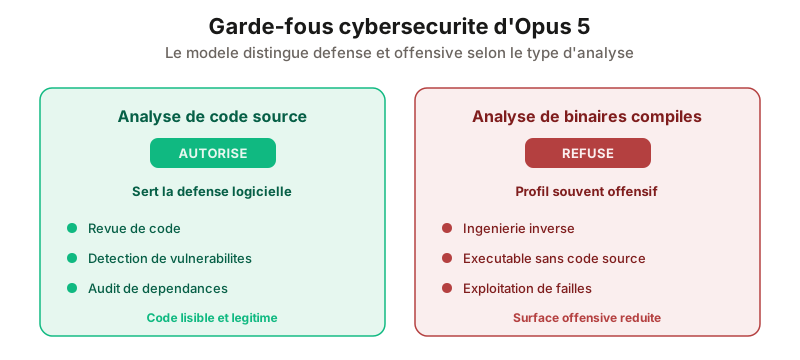 Opus 5 autorise l’analyse de code source (defense) mais refuse celle des binaires compiles, un usage plus souvent associe a l’exploitation offensive.
Cas d’usage : où Opus 5 fait la différence
Opus 5 est particulièrement pertinent sur trois familles de tâches où la combinaison performance frontière + prix standard change l’équation économique.
Codage agentique de longue haleine
Sur les sessions de développement autonome — refactoring, résolution de tickets, implémentation de features complètes — Opus 5 approche les capacités de Fable 5 à moitié prix. Pour une équipe qui fait tourner des agents en continu, l’écart de tarif se traduit directement en économies mensuelles substantielles. C’est le cas d’usage où, d’après mes tests, le passage d’Opus 4.8 à Opus 5 se justifie le plus vite.
Sous-agents parallèles
Le niveau d’effort low combiné au tarif standard fait d’Opus 5 un modèle adapté aux architectures à sous-agents multiples. Lorsque vous lancez des dizaines de sous-tâches simples en parallèle, low réduit la consommation de tokens sur chacune, pendant que le modèle principal en high orchestre l’ensemble. Cette approche est au cœur des workflows d’orchestration modernes de Claude Code.
Revue de code
Opus 5 hérite et renforce l’honnêteté sur les défauts introduite avec Opus 4.8. En revue de code, il résiste à valider du code incorrect et signale proactivement les cas limites, les hypothèses non vérifiées et les patterns à risque. Combiné à sa capacité à analyser le code source pour la défense logicielle, il constitue un relecteur exigeant sur les enjeux de qualité comme de sécurité.
Comment accéder à Opus 5
Opus 5 est disponible immédiatement sur l’ensemble des surfaces Anthropic, sans restriction géographique.
Sur Claude.ai, sélectionnez « Claude Opus 5 » dans le sélecteur de modèle, puis réglez le niveau d’effort via le toggle adjacent. Opus 5 devient le modèle par défaut sur Claude Max et le modèle le plus performant accessible sur Claude Pro.
Via l’API Anthropic, utilisez l’identifiant claude-opus-5. Le paramètre effort accepte low, medium et high.
Sur les clouds, Opus 5 est disponible sur Amazon Bedrock (anthropic.claude-opus-5), Google Cloud Vertex AI (claude-opus-5) et Microsoft Foundry.
Migration depuis Opus 4.8
La migration est simple dans la majorité des cas : remplacez l’identifiant de modèle.
# Avant
model = "claude-opus-4-8"

# Après
model = "claude-opus-5"
Le prix est identique (5 $ / 25 $), le contexte reste de 1M tokens, et les contraintes d’API héritées d’Opus 4.8 sont conservées : temperature, top_p et top_k ne sont pas supportés, et le thinking se pilote via thinking: {"type": "adaptive"} combiné au paramètre effort. Le principal point d’attention est le passage de cinq à trois niveaux d’effort : si votre code utilisait xhigh ou max, mappez-les sur high.
Ce qu’il faut retenir
Opus 5 est le lancement Anthropic le plus intéressant sur le plan du rapport performance/prix depuis Opus 4.8. En atteignant 43,3 % sur Frontier-Bench — devant Fable 5 et GPT-5.6 Sol — tout en conservant le tarif standard de 5 $ / 25 $, il rend la performance de niveau frontière accessible sans le surcoût ni les contraintes géographiques de Fable 5.
Mon avis : la migration depuis Opus 4.8 est recommandée sans réserve. Prix inchangé, contexte inchangé, gains nets sur Frontier-Bench, OSWorld 2.0 et ARC-AGI 3, garde-fous renforcés. Il n’y a pas de raison de rester sur Opus 4.8, sauf dépendance spécifique non testée.
Face à Fable 5, l’arbitrage dépend de votre contexte. Si vous êtes aux États-Unis, avec un budget confortable et des tâches de codage extrêmes (migration de dizaines de millions de lignes), Fable 5 conserve un léger avantage brut. Pour tout le reste — et pour tous les utilisateurs hors États-Unis — Opus 5 est désormais le meilleur choix par défaut. Pour situer Opus 5 dans la gamme complète, notre comparatif Opus vs Sonnet sera mis à jour avec les nouvelles données.