Claude Sonnet 5 : le guide du modèle mid-tier
Claude Sonnet 5 est le nouveau modèle mid-tier d’Anthropic, lancé le 30 juin 2026. Fait inédit pour un Sonnet : il dépasse le flagship Opus 4.8 sur Terminal-Bench 2.1 (80,4 % contre 74,6 %) tout en coûtant plusieurs fois moins cher, avec un tarif de lancement de 2 $ par million de tokens en entrée et 10 $ en sortie.
Concrètement, Sonnet 5 est la réponse d’Anthropic à une demande précise : faire tourner des agents en continu sans exploser les coûts. Ce guide couvre le positionnement du modèle, ses benchmarks (63,2 % sur SWE-bench Pro), son nouveau tokenizer qui change l’équation du coût réel, le thinking adaptatif activé par défaut, et une grille de décision claire pour choisir entre Sonnet 5 et Opus 5. Les données proviennent de l’annonce officielle d’Anthropic et de la documentation technique du modèle.
Ce qui change avec Sonnet 5 : un mid-tier qui joue dans la cour du flagship
Sonnet 5 est le premier modèle Sonnet à battre le flagship Opus de sa génération sur un benchmark de codage majeur. C’est un basculement de positionnement : la frontière entre « milieu de gamme » et « haut de gamme » devient une question de coût plus que de capacité brute.
Rappelons la logique de gamme d’Anthropic. Opus est la ligne flagship, taillée pour le raisonnement le plus profond et le codage agentique le plus lourd. Sonnet est la ligne mid-tier, optimisée pour le meilleur compromis vitesse/intelligence. Haiku reste l’entrée de gamme pour les tâches simples à fort volume.
Avec la génération 5, Sonnet se rapproche nettement du flagship. Anthropic décrit sa performance comme « proche de celle d’Opus 4.8, mais à des prix inférieurs ». Sur les courbes coût/performance, Sonnet 5 offre un éventail d’arbitrages plus large et atteint parfois le niveau d’Opus 4.8 en réglant l’effort au maximum.
| Modèle | Positionnement | Prix entrée / sortie | Contexte |
|---|---|---|---|
| Opus 5 | Flagship | 5 $ / 25 $ par MTok | 1M tokens |
| Sonnet 5 | Mid-tier | 2 $ / 10 $* par MTok | 1M tokens |
| Sonnet 4.6 | Mid-tier (précédent) | 3 $ / 15 $ par MTok | 1M tokens |
*Tarif de lancement en vigueur jusqu’au 31 août 2026 ; tarif standard ensuite : 3 $ / 15 $ par MTok.
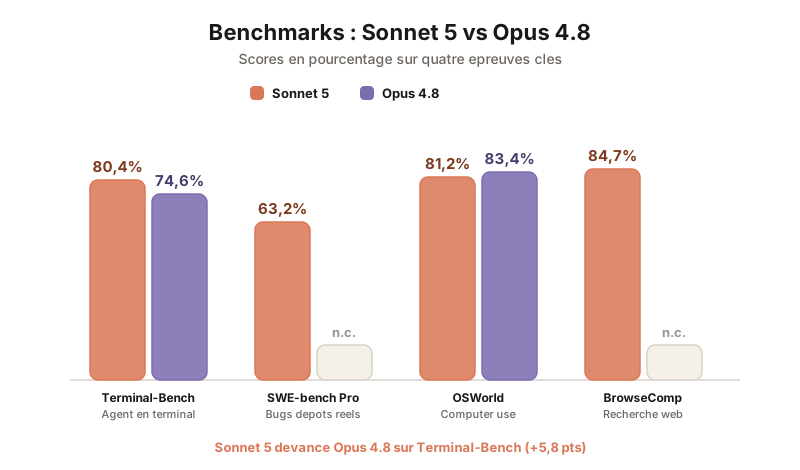 Sonnet 5 devance Opus 4.8 sur Terminal-Bench 2.1 (80,4 % contre 74,6 %, soit +5,8 points).
Benchmarks : Sonnet 5 dépasse Opus 4.8 sur Terminal-Bench
Sonnet 5 obtient 80,4 % sur Terminal-Bench 2.1, un score qui dépasse celui d’Opus 4.8 (74,6 %). Terminal-Bench mesure la capacité d’un modèle à accomplir des tâches réelles dans un terminal — enchaîner des commandes, manipuler des fichiers, déboguer un environnement — comme le ferait un agent autonome. C’est la première fois qu’un modèle Sonnet devance le flagship Opus de sa génération sur ce type d’épreuve.
Le tableau ci-dessous situe Sonnet 5 face à son prédécesseur direct et à Opus 4.8.
| Benchmark | Sonnet 5 | Opus 4.8 | Ce qu’il mesure |
|---|---|---|---|
| Terminal-Bench 2.1 | 80,4 % | 74,6 % | Tâches agentiques en terminal |
| SWE-bench Pro | 63,2 % | — | Résolution de bugs sur dépôts réels |
| OSWorld-Verified | 81,2 % | 83,4 % | Computer use, pilotage d’interfaces |
| BrowseComp | 84,7 % | — | Recherche agentique sur le web |
Trois enseignements ressortent de ces résultats.
Le codage agentique est le point fort de Sonnet 5. Les plus gros gains par rapport à Sonnet 4.6 se concentrent sur les tâches de code et d’agent. Sur Terminal-Bench comme sur SWE-bench Pro, Sonnet 5 se hisse à un niveau qui, sur la génération précédente, était l’apanage des modèles Opus. C’est le cas d’usage qui justifie le plus vite la migration.
GDPval valide le travail de connaissance. Anthropic met en avant les progrès de Sonnet 5 sur GDPval, un benchmark qui évalue des tâches de travail économiquement utiles (analyse, rédaction, synthèse) plutôt que du pur codage. Sonnet 5 s’y montre compétitif face à Opus 4.8, ce qui élargit son intérêt au-delà des développeurs.
Le computer use reste un cran derrière Opus. Sur OSWorld-Verified (81,2 %), Sonnet 5 est proche mais légèrement en retrait d’Opus 4.8 (83,4 %). Pour les usages de computer use les plus exigeants, l’écart peut justifier de rester sur un modèle Opus.
Il faut lire ces scores avec une réserve importante : ils comparent Sonnet 5 à Opus 4.8, pas à Opus 5. Le nouveau flagship Opus 5, lancé fin juillet 2026, reprend l’avantage sur les tâches de raisonnement les plus lourdes. Sonnet 5 ne remplace pas le flagship de sa propre génération ; il rend le niveau flagship de la génération précédente accessible à moindre coût.
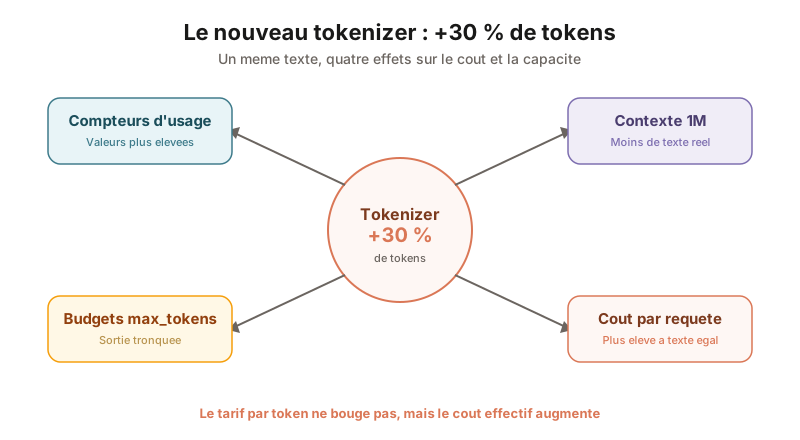 Le tarif par token ne change pas, mais le nouveau tokenizer (+30 % de tokens) augmente le coût effectif de chaque requête.
Le nouveau tokenizer : attention au coût réel
Sonnet 5 utilise un nouveau tokenizer qui produit environ 30 % de tokens en plus pour un même texte, par rapport à Sonnet 4.6. C’est le point technique le plus important à comprendre avant de migrer, car il modifie l’économie réelle du modèle sans toucher au tarif affiché.
Le prix par token est inchangé (2 $ / 10 $ au lancement), mais comme le même texte génère davantage de tokens, le coût effectif d’une requête équivalente augmente. Sur une longue session — un agent qui tourne des heures sur un gros dépôt — cet effet se cumule et peut représenter une différence sensible sur la facture mensuelle.
Ce changement touche tout ce qui se mesure en tokens.
- Les compteurs d’usage : les champs
usagerenvoient des valeurs plus élevées pour le même texte. Ne réutilisez pas les comptages effectués sur les modèles précédents ; recomptez sur Sonnet 5. - La capacité réelle du contexte : la fenêtre reste à 1M tokens, mais chaque token couvre moins de texte en moyenne. Le contexte contient donc moins de texte qu’avec Sonnet 4.6.
- Les budgets
max_tokens: une limite de sortie calibrée pour Sonnet 4.6 peut tronquer une sortie équivalente sur Sonnet 5. Révisez les limites proches de votre longueur de réponse attendue. - Le coût par requête : à texte égal, une requête coûte davantage. C’est le point à surveiller de près sur les workflows à fort volume.
Mon conseil : avant de basculer un pipeline en production, recomptez vos prompts types avec l’outil de token counting et réévaluez votre budget mensuel avec la marge de +30 %. Cette gestion fine du coût par requête rejoint la logique de routage détaillée dans notre guide de l’Effort Control.
Le thinking adaptatif, activé par défaut
Sonnet 5 active le thinking adaptatif par défaut, un changement de comportement notable par rapport à Sonnet 4.6. Sur l’ancien modèle, une requête sans champ thinking s’exécutait sans raisonnement. Sur Sonnet 5, la même requête déclenche un raisonnement adaptatif, où le modèle module lui-même la profondeur de sa réflexion selon la difficulté de la tâche.
Ce comportement a des conséquences pratiques qu’il vaut mieux anticiper.
Le raisonnement compte dans max_tokens. Comme max_tokens est une limite dure sur la sortie totale (raisonnement plus texte de réponse), une valeur qui convenait sans thinking sur Sonnet 4.6 peut désormais tronquer la réponse. Il faut réévaluer cette limite sur les charges de travail qui tournaient sans raisonnement.
Le thinking peut être verbeux. Le raisonnement adaptatif de Sonnet 5 produit des chaînes de pensée parfois longues, en particulier au niveau d’effort élevé. C’est un atout pour la qualité, mais cela consomme des tokens de sortie — les plus chers. Sur des tâches simples et répétitives, désactiver le thinking (thinking: {type: "disabled"}) reste pertinent.
Le thinking manuel est supprimé. Le thinking étendu manuel (thinking: {type: "enabled", budget_tokens: N}) renvoie une erreur 400. Il faut utiliser le thinking adaptatif combiné au paramètre effort :
import anthropic
client = anthropic.Anthropic()
response = client.messages.create(
model="claude-sonnet-5",
max_tokens=8192,
thinking={"type": "adaptive"},
messages=[{"role": "user", "content": "Refactore ce module et écris les tests."}]
)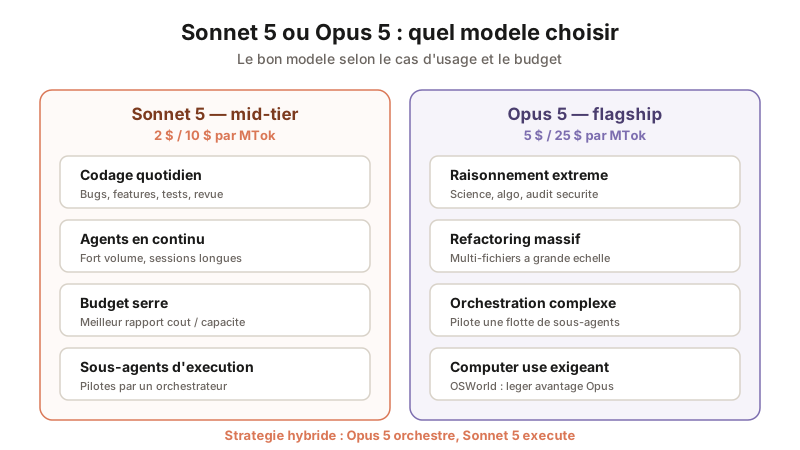 Sonnet 5 pour le flux de travail normal et le fort volume ; Opus 5 pour le raisonnement extrême. La stratégie hybride combine les deux : Opus 5 orchestre, Sonnet 5 exécute.
Quand choisir Sonnet 5 plutôt qu’Opus 5
Sonnet 5 couvre la grande majorité des tâches de codage et de bureautique à une fraction du coût d’Opus 5 ; réservez le flagship aux problèmes de raisonnement les plus lourds et aux workflows multi-agents exigeants. C’est la règle simple, que voici détaillée par cas d’usage.
| Critère | Sonnet 5 | Opus 5 |
|---|---|---|
| Prix entrée / sortie | 2 $ / 10 $* par MTok | 5 $ / 25 $ par MTok |
| Codage quotidien (bugs, features, tests) | Recommandé | Surdimensionné |
| Agents en continu / fort volume | Recommandé | Coûteux |
| Raisonnement scientifique, refactoring massif | Possible | Recommandé |
| Orchestration multi-agents complexe | Sous-agents | Orchestrateur |
| Budget serré | Recommandé | À réserver |
*Tarif de lancement jusqu’au 31 août 2026.
Choisissez Sonnet 5 pour le codage quotidien. Correction de bugs, implémentation de fonctionnalités, écriture de tests, revue de code courante : Sonnet 5 traite ces tâches à un niveau qui, il y a une génération, exigeait un modèle Opus. Sur mes projets, c’est devenu le modèle par défaut pour tout ce qui relève du flux de travail normal.
Choisissez Sonnet 5 pour les agents en continu. C’est précisément le cas d’usage qu’Anthropic vise avec ce lancement : faire tourner des agents pendant des heures sans que la facture ne devienne prohibitive. Le tarif de lancement rend l’économie particulièrement favorable sur les architectures à fort volume de requêtes.
Gardez Opus 5 pour le raisonnement extrême. Refactoring multi-fichiers à grande échelle, audit de sécurité approfondi, problèmes scientifiques ou algorithmiques complexes, orchestration d’une flotte de sous-agents : sur ces tâches, l’écart de capacité justifie le surcoût. Une stratégie hybride efficace consiste à faire orchestrer Opus 5 et exécuter les sous-tâches par des instances Sonnet 5. Cette approche de routage est au cœur des workflows modernes de Claude Code.
Pour situer Sonnet 5 dans la gamme complète et arbitrer plus finement, notre comparatif Opus vs Sonnet détaille les critères de choix modèle par modèle.
Comment accéder à Sonnet 5
Sonnet 5 est disponible immédiatement sur l’ensemble des surfaces Anthropic, y compris l’offre gratuite.
Sur Claude.ai, Sonnet 5 est le modèle par défaut pour tous les utilisateurs des offres gratuite et Pro depuis le lancement. Il est aussi accessible aux abonnés Max, Team et Enterprise. C’est un point notable : le grand public bénéficie du modèle mid-tier de dernière génération sans abonnement payant. Pour comprendre ce que couvre exactement l’offre gratuite, consultez notre guide de Claude gratuit.
Via l’API Anthropic, utilisez l’identifiant claude-sonnet-5, accessible à tous les clients. La fenêtre de contexte est de 1M tokens par défaut (à la fois défaut et maximum), avec 128k tokens de sortie. Le Priority Tier n’est pas disponible sur Sonnet 5.
Sur les clouds, Sonnet 5 est disponible sur Amazon Bedrock, Google Cloud Vertex AI et Microsoft Foundry.
Migration depuis Sonnet 4.6
Sonnet 5 est un remplaçant direct de Sonnet 4.6. La migration consiste d’abord à changer l’identifiant de modèle.
model = "claude-sonnet-4-6"  # Avant
model = "claude-sonnet-5"    # Après
Trois points de vigilance ensuite. Premièrement, recomptez vos tokens : le nouveau tokenizer produit environ 30 % de tokens en plus, révisez vos budgets et vos max_tokens. Deuxièmement, retirez les paramètres d’échantillonnage : temperature, top_p et top_k avec une valeur non par défaut renvoient une erreur 400 ; guidez le comportement par le prompt système. Troisièmement, migrez le thinking : le thinking manuel n’est plus supporté, passez au thinking adaptatif avec le paramètre effort.
Notez aussi que Sonnet 5 est le premier modèle Sonnet doté de garde-fous cybersécurité en temps réel. Les requêtes portant sur des sujets à haut risque peuvent être refusées ; le refus arrive comme une réponse HTTP 200 avec stop_reason: "refusal", et non comme une erreur.
Ce qu’il faut retenir
Sonnet 5 déplace la ligne de partage entre mid-tier et flagship. En battant Opus 4.8 sur Terminal-Bench 2.1 (80,4 % contre 74,6 %) et en atteignant 63,2 % sur SWE-bench Pro, il rend un niveau de capacité récemment réservé au flagship accessible à un tarif de lancement de 2 $ / 10 $. Pour le codage quotidien et les agents en continu, c’est désormais le choix par défaut.
Mon avis : la migration depuis Sonnet 4.6 se justifie dans la quasi-totalité des cas, à condition d’intégrer le point de vigilance central — le nouveau tokenizer ajoute environ 30 % de tokens, donc de coût effectif, sur un même texte. Sur de longues sessions agentiques, recalculez votre budget avant de basculer en production.
Face à Opus 5, l’arbitrage est clair : Sonnet 5 pour le flux de travail normal et le fort volume, Opus 5 pour le raisonnement extrême et l’orchestration complexe. La stratégie la plus efficace combine les deux — Opus 5 orchestre, Sonnet 5 exécute. Pour choisir modèle par modèle selon votre contexte, notre comparatif Opus vs Sonnet reste la référence à jour.