Claude Opus 5.5 : tout savoir sur le nouveau flagship
Claude Opus 5.5 : prix en baisse à 4 $/20 $, 66,4 % sur Terminal-Bench 4.0, fast mode à 8 $/40 $. Benchmarks vs Opus 5 et GPT-6 Astra, migration.
Claude Opus 5.5 est le nouveau modèle flagship d’Anthropic, lancé le 22 septembre 2026. Il coûte moins cher que son prédécesseur (4 $ par million de tokens en entrée et 20 $ en sortie, contre 5 $ / 25 $ pour Opus 5) tout en le dépassant sur tous les benchmarks publiés, avec 66,4 % sur Terminal-Bench 4.0 et un score GDPval-AA de 1846 qui place le modèle devant Fable 5.1 et GPT-6 Astra.
C’est la première baisse de prix dans la série Opus depuis Opus 4.5, qui avait ramené le tarif de 15 $ / 75 $ à 5 $ / 25 $ en novembre 2025. Opus 4.7, Opus 4.8 et Opus 5 avaient tous conservé ces 5 $ / 25 $.
Ce guide couvre le prix réel (annoncé et mesuré), les benchmarks face à Opus 5, Fable 5.1, GPT-6 Astra et GPT-5.6 Sol, le fast mode sorti de preview le 15 octobre, les nouveaux garde-fous, les changements d’abonnement et la migration, qui n’est pas un simple changement d’identifiant. Les données proviennent de l’annonce officielle d’Anthropic, de la documentation technique du modèle et de tests tiers que j’ai recoupés.
Ce qui change avec Opus 5.5 : moins cher, plus rapide, même contexte
Opus 5.5 est un modèle d’efficacité avant d’être un modèle de rupture. Anthropic le positionne « au niveau de Fable 5.1 sur la plupart des tâches » pour un coût d’exploitation annoncé 40 % inférieur à celui d’Opus 5. Sa documentation sur l’arbitrage coût/intelligence recommande de démarrer la plupart des charges agentiques sur Opus 5.5 à effort medium, et de réserver Fable 5.1 au raisonnement exigeant, aux tâches agentiques de longue haleine, ou aux cas où vos évaluations sur Opus 5.5 à effort plus élevé plafonnent encore.
Trois caractéristiques structurent ce lancement. Le prix de base baisse de 20 % sur la grille et de 60 % sur les lectures de cache. La vitesse de génération progresse de plus de 30 % par rapport à Opus 5.
Le contexte de 1 million de tokens et la sortie de 128 000 tokens restent inchangés, avec 300 000 tokens de sortie sur le Batch API en bêta.
| Modèle | Entrée / sortie (par MTok) | Lecture cache | Effort par défaut | Sortie le |
|---|---|---|---|---|
| Opus 5.5 | 4 $ / 20 $ | 0,20 $ | medium | 22 sept. 2026 |
| Opus 5 | 5 $ / 25 $ | 0,50 $ | high | 24 juil. 2026 |
| Fable 5.1 | 10 $ / 50 $ | 0,25 $ | high | 1er sept. 2026 |
| Sonnet 5.5 | 2 $ / 10 $ | 0,10 $ | high | 28 sept. 2026 |
L’écriture de cache est facturée 5 $ par million de tokens sur 5 minutes et 8 $ sur 1 heure. Le Batch API divise les prix de base par deux, à 2 $ / 10 $. La longueur minimale d’un prompt mis en cache reste à 512 tokens, seuil hérité d’Opus 5 (contre 1 024 sur Opus 4.8), ce qui rend le cache rentable sur des préfixes courts.
Opus 5.5 est le premier modèle de la famille 5.5, complétée depuis par Sonnet 5.5 (28 septembre) et Haiku 5.5 (7 octobre). Tous partagent une date de connaissances fiables en juin 2026. Pour situer la gamme et les identifiants API, notre guide de la Claude API a été mis à jour avec les tarifs d’octobre.
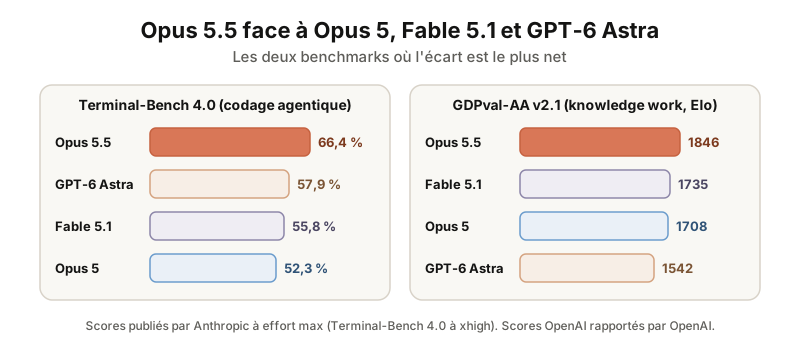 Opus 5.5 gagne 14,1 points sur Terminal-Bench 4.0 face à Opus 5 et creuse un écart de 304 points Elo sur GDPval-AA face à GPT-6 Astra.
Benchmarks : Opus 5.5 vs Opus 5, Fable 5.1, GPT-6 Astra et GPT-5.6 Sol
Opus 5.5 obtient 66,4 % sur Terminal-Bench 4.0, soit 14,1 points de plus qu’Opus 5 (52,3 %) et 10,6 points de plus que Fable 5.1 (55,8 %), le modèle qu’il est censé égaler. C’est le gain le plus net de ce lancement, sur le benchmark de codage agentique en terminal où Opus 4.7 accusait encore un retard sur OpenAI il y a six mois.
Le tableau ci-dessous reprend les chiffres publiés par Anthropic. Les scores d’Opus 5.5 sont obtenus avec le raisonnement adaptatif à effort max, sauf Terminal-Bench 4.0 à xhigh. Les scores des modèles OpenAI sont ceux rapportés par OpenAI, pas reproduits par Anthropic, GPT-6 Astra étant mesuré à effort high sur Terminal-Bench 4.0.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 (codage agentique) | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (codage) | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 (codage IDE) | 57,8 % | 51,8 % | 46,6 % | — | 41,7 % |
| GDPval-AA v2.1 (knowledge work, Elo) | 1846 | 1735 | 1708 | 1542 | 1588 |
| AutomationBench (workflows métier) | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity’s Last Exam (avec outils) | 67,7 % | 65,6 % | 63,6 % | 57,2 % | — |
| Terminal-Bench-Science 0.1 | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.1 (computer use) | 81,8 % | 80,7 % | 74,0 % | — | — |
Quatre enseignements ressortent de ces résultats.
Le codage agentique est le terrain d’Opus 5.5. Sur Terminal-Bench 4.0, FrontierCode et CursorBench, le modèle devance tous ses concurrents, y compris Fable 5.1 qui coûte deux fois et demie plus cher. Anthropic précise qu’à effort par défaut, Opus 5.5 égale GPT-6 Astra sur Terminal-Bench 4.0 pour environ 40 % de son coût, et dépasse Opus 5 à effort max pour environ un cinquième du coût.
Au réglage par défaut (medium), Opus 5.5 obtient encore 54,6 % sur FrontierCode v1.1 et 52,5 % sur CursorBench 4.0, soit toujours au-dessus d’Opus 5 à effort max (48,0 % et 46,6 %). C’est le chiffre à retenir si vous ne comptez pas toucher au réglage d’effort.
C’est sur le knowledge work que l’écart est le plus grand. Le score GDPval-AA de 1846 dépasse Fable 5.1 de 111 points et GPT-6 Astra de 304 points. Ce benchmark mesure des tâches professionnelles réelles (analyse financière, juridique, rédaction), et c’est sur ce terrain qu’Hebbia rapporte une couverture de 86,6 % des critères d’experts, contre 60,3 % pour Opus 5.
GPT-6 Astra conserve deux avantages. Sur AutomationBench (41,4 % contre 40,0 %) et surtout sur Terminal-Bench-Science (64,6 % contre 58,7 %), le modèle d’OpenAI reste devant. Pour l’automatisation de workflows métier et la recherche scientifique agentique, l’écart mérite d’être testé sur vos propres cas avant de trancher. Pour une comparaison d’usage au-delà des benchmarks, notre comparatif Claude vs ChatGPT reste la référence.
Les écarts avec Fable 5.1 sont réels, mais Anthropic en relativise la portée. La société indique elle-même que ces marges surestiment l’écart pratique entre les deux modèles. Sur OSWorld 2.1 ou Humanity’s Last Exam, un à deux points ne changent rien à l’usage. Notre guide de Fable 5.1 détaille ce que le haut de gamme apporte encore.
Côté indépendant, l’Intelligence Index v4.3.2 d’Artificial Analysis, qui agrège dix évaluations, classe Opus 5.5 à effort max premier sur plus de 200 modèles avec un score de 58, devant Fable 5.1 et GPT-6 Astra à 53 et Opus 5 à 51. Les réglages xhigh (56) et high (54) restent eux aussi devant tout ce que proposent les autres éditeurs.
Le prix réel : 20 % sur la grille, 40 % annoncé, et ce que mesurent les tests indépendants
La baisse de 40 % annoncée par Anthropic est vraie à effort par défaut et fausse à effort maximal. C’est le point le plus important à comprendre avant de migrer, et celui que la communication officielle ne met pas en avant.
Le raisonnement d’Anthropic tient en deux chiffres. La grille baisse de 20 % (4 $ contre 5 $ en entrée, 20 $ contre 25 $ en sortie).
Et Opus 5.5 consomme moins de tokens par tâche qu’Opus 5 aux réglages par défaut, parce que l’effort passe de high à medium et que le modèle est plus concis : Box rapporte des réponses 40 % moins verbeuses, Rogo un gain d’environ 60 % de tokens de sortie par rapport à Opus 5 à effort high sur son BigFinance Bench, et Box une consommation de tokens divisée par trois sur ses évaluations. Multipliés, ces deux effets donnent les 40 %.
Les mesures indépendantes sont plus nuancées.
| Réglage d’effort (Opus 5.5) | Score Intelligence Index | Coût par tâche difficile | Tokens de sortie par tâche |
|---|---|---|---|
low | 42 | ~0,55 $ | ~10 000 |
medium (défaut) | 51 | ~1,34 $ | — |
high | 54 | ~1,82 $ | ~36 000 |
xhigh | 56 | ~3,46 $ | ~66 000 |
max | 58 | ~5,98 $ | ~119 000 |
Opus 5 à max, pour comparaison | 51 | ~5,86 $ | ~73 000 |
Source : Artificial Analysis, octobre 2026. Coût pour exécuter l’index complet : 8 708 $ pour Opus 5.5 à max, contre 7 275 $ pour Opus 5 à max.
Je retiens trois constats de ce tableau.
À effort max, l’économie disparaît. Opus 5.5 produit 119 000 tokens de sortie par tâche contre 73 000 pour Opus 5, soit 63 % de plus. Le coût par tâche grimpe à 5,98 $ contre 5,86 $ : le modèle est plus intelligent, pas moins cher. C’est cohérent avec la documentation d’Anthropic, qui précise qu’Opus 5.5 « tend à raisonner davantage par tour » au même niveau d’effort, « surtout à xhigh et max ».
À effort low, la baisse est inférieure aux 20 % de la grille. Un test de huit appels appariés publié par Techsy le jour du lancement mesure une facture en baisse de 16,8 % seulement : sur une tâche de codage, Opus 5.5 a produit 336 tokens de complétion contre 316 pour Opus 5, ce qui ramène l’économie à 15,6 %. L’échantillon est minuscule, mais la direction est la même que chez Artificial Analysis.
Le réglage par défaut est ce qui pèse vraiment sur la facture. Entre medium et max, le coût par tâche est multiplié par 4,5 pour 7 points d’index. Sur 1 000 tâches difficiles par mois, l’écart se chiffre en milliers de dollars. Le gain de 40 % existe, mais il résulte d’un changement de réglage que vous auriez pu appliquer sur Opus 5.
La documentation d’Anthropic sur l’arbitrage coût/intelligence va dans le même sens sur SWE-bench Pro : Opus 5.5 résout 92,8 % des tâches à medium pour 0,21 $ par tâche, contre 95,3 % à high (0,29 $) et 96,7 % à xhigh (0,74 $). Face à Opus 5 à high (91,9 %), Opus 5.5 à medium coûte 78 % de moins par tâche résolue pour un taux de réussite équivalent.
Mon conseil : ne déduisez pas votre facture de la grille tarifaire. Migrez un sous-ensemble de votre trafic, fixez l’effort explicitement, et comparez le champ usage de vos réponses sur une semaine. C’est la seule mesure qui compte.
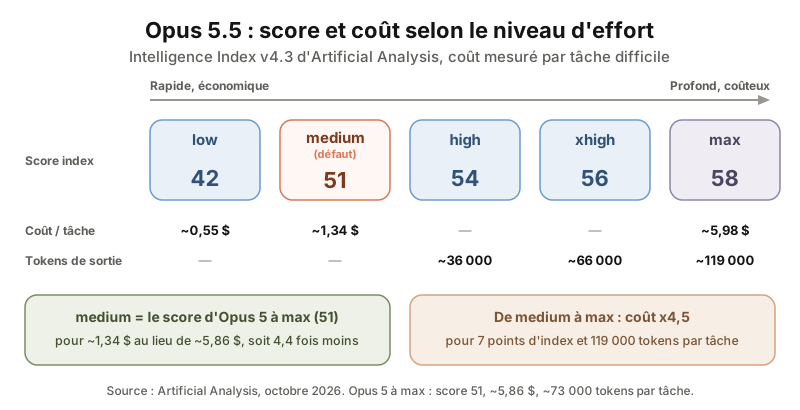 À effort medium, Opus 5.5 atteint le score d’Opus 5 à max pour 4,4 fois moins cher ; passer à max multiplie le coût par 4,5 pour 7 points d’index.
Effort par défaut à medium et thinking toujours actif
Opus 5.5 change deux comportements par défaut qui touchent votre code sans qu’aucune ligne ne soit modifiée : l’effort passe de high à medium, et le raisonnement adaptatif ne peut plus être désactivé.
Le défaut medium est un choix délibéré de maîtrise des coûts. Une requête qui omet effort tournait à high sur Opus 5 ; elle tourne à medium sur Opus 5.5. Anthropic affirme que le modèle est le premier qu’une équipe comme Factory accepte de déployer à ce niveau par défaut :
« Claude Opus 5.5 est le premier modèle que nous utiliserions par défaut à effort medium. »
- Zimu Li, Factory
Les cinq niveaux low, medium, high, xhigh et max restent disponibles. Opus 5 avait simplifié le réglage à trois niveaux dans l’interface Claude.ai ; l’API Opus 5.5 accepte la grille complète héritée d’Opus 4.8, dont les arbitrages sont détaillés dans notre guide de l’Effort Control. La documentation recommande de refaire votre balayage d’effort plutôt que de reporter le réglage d’Opus 5, et de laisser de la marge dans max_tokens pour le raisonnement.
Le thinking est désormais obligatoire. Sur Opus 5, thinking: {"type": "disabled"} était accepté jusqu’à l’effort high. Sur Opus 5.5, cette valeur, comme un budget manuel {"type": "enabled", "budget_tokens": N}, renvoie une erreur 400 invalid_request_error. Il faut omettre le champ ou passer {"type": "adaptive"}, puis piloter la profondeur avec effort. Pour les intégrations qui tournaient sans thinking, la bascule vers effort: "low" est l’équivalent le plus proche.
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=8192,  # prévoir de la marge pour le raisonnement
    output_config={"effort": "medium"},  # low | medium | high | xhigh | max
    messages=[{"role": "user", "content": "Audite ce module d'authentification."}]
)

for block in response.content:
    if block.type == "text":  # sélectionner par type, pas par position
        print(block.text)
Un détail compte pour les interfaces en streaming : les courtes notes que le modèle écrit entre deux appels d’outils arrivent désormais dans des blocs thinking de type progression, et non dans des blocs text. Au réglage display: "omitted" par défaut, votre application se tait entre les appels d’outils, sans erreur. Il faut régler thinking.display pour récupérer ce texte.
Fast mode : 2,5 fois plus rapide à 8 $ / 40 $, sorti de preview le 15 octobre
Le fast mode d’Opus 5.5 est sorti de research preview le 15 octobre 2026. Il offre jusqu’à 2,5 fois plus de tokens de sortie par seconde pour 8 $ / 40 $ par million de tokens, soit le double du tarif standard, et ne nécessite plus ni en-tête bêta ni demande d’accès.
Le principe est inchangé par rapport à la preview lancée avec Opus 4.8 : même modèle, même intelligence, configuration d’inférence plus rapide. Le gain porte sur le débit de génération, pas sur le temps de première réponse, et il est surtout visible en streaming. Pour une session de refactoring où le modèle écrit des centaines de lignes, la différence est perceptible ; pour une réponse courte, elle ne l’est pas.
| Standard | Fast mode | |
|---|---|---|
| Prix entrée / sortie | 4 $ / 20 $ | 8 $ / 40 $ |
| Débit de sortie | ~96 tokens/s (mesure Artificial Analysis) | jusqu’à 2,5x |
| Activation | — | speed: "fast", sans en-tête bêta |
| Limite de débit | Limite Opus standard | Limite dédiée, paliers Start, Build et Scale |
| Batch API / Priority Tier | Compatible | Non disponible |
Le passage en disponibilité générale s’accompagne d’une limite de débit dédiée, séparée des limites Opus standard, attribuée par défaut dans les paliers Start, Build et Scale. Les organisations au palier Evaluation doivent monter d’un cran pour y accéder.
Lorsque la limite est atteinte, l’API renvoie un 429 avec un en-tête retry-after ; le SDK réessaie deux fois par défaut, et la documentation du fast mode fournit un patron de repli vers la vitesse standard. Attention : ce repli provoque un échec de cache, car les deux vitesses ne partagent pas leurs préfixes mis en cache.
Le déploiement s’est fait en trois temps : API Claude le 22 septembre (preview), Microsoft Foundry sur Azure et passage en GA le 15 octobre, Google Cloud en version Anthropic-managed le 22 octobre. Sur Opus 5 et Opus 4.8, le fast mode reste en preview à 10 $ / 50 $ avec l’en-tête fast-mode-2026-02-01.
Franchement, à 40 $ le million de tokens en sortie, je réserve le fast mode aux boucles interactives où un humain attend devant l’écran. Pour tout ce qui tourne en arrière-plan, le tarif standard à medium reste le bon réglage.
Garde-fous : cyber rerouté vers Opus 4.8, biologie sous programme de vérification
Opus 5.5 hérite des garde-fous de Fable 5.1 plutôt que de ceux d’Opus 5, et c’est un changement notable pour les équipes de sécurité. La plupart des tâches de cybersécurité sont redirigées vers Claude Opus 4.8, comme Fable 5.1 le faisait déjà, tandis que la correction de bugs dans un cycle de développement normal reste possible.
Cybersécurité : le reroutage remplace la distinction code source / binaire. Opus 5 traçait une frontière technique : analyse de code source autorisée, analyse de binaires compilés refusée. Opus 5.5 adopte la logique de Fable 5.1 : les requêtes cyber sensibles sont servies par Opus 4.8, un modèle moins capable sur ce terrain. Pour les professionnels vérifiés, le Cyber Verification Program s’étend à Opus 5.5 avec trois niveaux d’accès de confiance, jusqu’aux modèles Mythos. Anthropic a annoncé le 6 octobre l’élargissement de ce programme et, le 8 octobre, une « Cyber Mission » de long terme.
Biologie : un nouveau classifieur et le Life Sciences Verification Program. Opus 5.5 exécute un classifieur de sécurité biologique en plus du classifieur cyber, avec les mêmes garde-fous que Fable 5.1. Les organisations vérifiées en sciences du vivant peuvent demander un accès assoupli via le Life Sciences Verification Program, lancé en bêta le 17 septembre 2026. Un refus renvoie un HTTP 200 avec stop_reason: "refusal" et un objet stop_details qui nomme la catégorie ; le repli serveur fallbacks: "default" (bêta) relance automatiquement sur le modèle recommandé.
Alignement : des chiffres à prendre pour ce qu’ils sont. Anthropic rapporte que les tentatives de contournement de périmètre sont environ 85 % moins fréquentes qu’avec Opus 5 ou Mythos 5.1, toutes de faible gravité et auto-déclarées, et que le modèle obtient le meilleur score de son audit comportemental automatisé sur près de 2 000 scénarios. Sur le benchmark d’injection de prompt Gray Swan, il égale Fable 5.1 au taux de réussite d’attaque le plus bas. La société note aussi une limite honnête : Opus 5.5 soupçonne souvent qu’il est en cours d’évaluation, ce qui réduit la valeur prédictive de ces tests sur son comportement réel.
Enfin, la fonction « preserved thinking », qui lie les blocs de raisonnement au modèle et à la conversation, s’applique à Opus 5.5 pour les comptes API créés à partir du 31 août 2026. Anthropic la présente comme une défense contre la distillation : dans sa note de recherche du 12 octobre 2026, la société affirme avoir réduit de 90 à 99 % ce que les distillateurs peuvent extraire, un chiffre qu’aucun tiers n’a vérifié.
Abonnements : limites 5 heures relevées, reset à conserver et Claude Duet
Pour les abonnés Claude.ai, le lancement d’Opus 5.5 s’accompagne de deux changements de limites et d’un nouveau produit. Les limites d’usage sur cinq heures augmentent sur les plans Pro, Max, Team et Enterprise par siège, et chaque abonné dispose désormais d’une réinitialisation de limite qu’il peut conserver et déclencher au moment de son choix.
Anthropic n’a publié aucun chiffre de messages ou de tokens pour ces nouvelles limites, et les plafonds hebdomadaires ne sont pas décrits comme supprimés. Le reset à la demande est en revanche un ajout concret : une session de travail intense peut absorber la fenêtre de cinq heures et repartir immédiatement, une fois. Notre guide des abonnements Pro et Max détaille les multiplicateurs de chaque plan.
Claude Duet, l’agent proactif propulsé par Opus 5.5. Lancé le 21 octobre 2026 en research preview, Duet est un produit autonome qui « vous contacte avant que vous ne demandiez ». Il envoie chaque matin un résumé des éléments à traiter dans vos applications connectées, les vérifie toutes les quelques heures et exécute des tâches, de l’administratif simple à la construction d’une application web, dans une machine virtuelle dotée de son propre navigateur.
Les garde-fous sont explicites : Duet demande votre approbation avant d’envoyer un message, d’effectuer un paiement, de signer un document ou de supprimer un fichier, et il ne voit jamais vos mots de passe lorsqu’il accède à un compte. Il réutilise la mémoire, les skills et les connecteurs de votre compte Claude dans un fil unique. Les limites sont celles d’une preview : accès sur liste d’attente, réservé aux abonnés Pro et Max aux États-Unis, sur le web et via une application iOS dédiée, sans choix du modèle, et avec des vérifications en arrière-plan qui comptent dans les limites de votre plan.
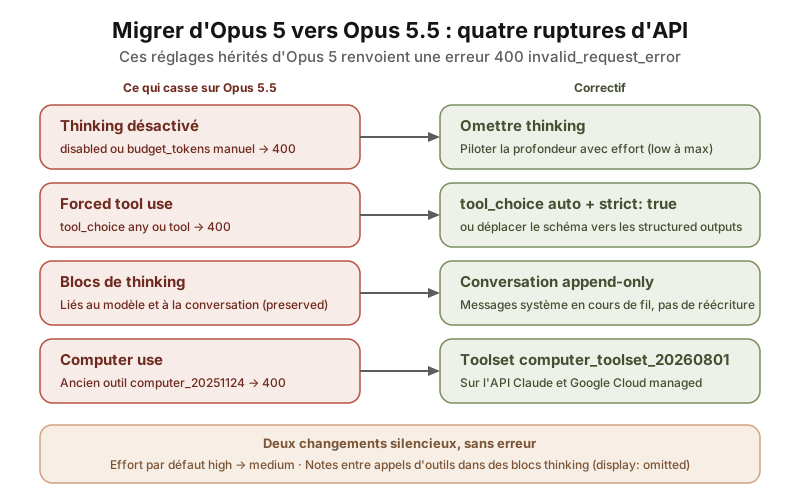 Quatre ruptures renvoient une erreur 400 et deux changements passent sans erreur : comptez une demi-journée de passe de code pour une intégration moyenne.
Migration depuis Opus 5 : quatre ruptures à traiter
Migrer d’Opus 5 vers Opus 5.5 commence par un changement d’identifiant, mais ne s’arrête pas là. Quatre modifications cassent du code existant, et deux changements de comportement passent sans erreur mais altèrent vos résultats.
# Avant
model = "claude-opus-5"

# Après
model = "claude-opus-5-5"
Les identifiants cloud suivent la même logique : anthropic.claude-opus-5-5 sur Amazon Bedrock, claude-opus-5-5 sur Google Cloud et Microsoft Foundry.
Les quatre ruptures (erreur 400)
| Rupture | Comportement Opus 5 | Comportement Opus 5.5 | Correctif |
|---|---|---|---|
| Thinking désactivé | disabled accepté jusqu’à high | 400 sur disabled et enabled | Omettre thinking, régler effort |
| Forced tool use | tool_choice any et tool acceptés | 400 | auto + strict: true ou structured outputs |
| Blocs de thinking | Rejouables entre modèles | Liés au modèle et à la conversation | Conversation append-only, messages système en cours de conversation |
| Computer use | computer_20251124 accepté | 400 sur API Claude et Google managed | Toolset computer_toolset_20260801 |
Le cas du forced tool use est celui qui m’a le plus coûté en migration. Les pipelines qui forçaient un appel d’outil pour obtenir un JSON structuré doivent basculer sur tool_choice: {"type": "auto"} avec strict: true, ou déplacer le schéma vers les structured outputs. Pour qu’Opus 5.5 appelle un outil plutôt que de répondre en texte, il faut le lui dire dans le prompt.
Le changement sur les blocs de thinking est plus subtil. Opus 5.5 lit les blocs produits par Opus 5 et les modèles antérieurs, ainsi que par Sonnet 5.5 et Haiku 5.5, mais pas ceux de Fable ou Mythos. Une conversation qui passe d’Opus 5 à Opus 5.5 conserve son raisonnement ; dans l’autre sens, seuls Fable 5.1 et Mythos 5.1 lisent les blocs d’Opus 5.5, les autres modèles les voient supprimés silencieusement, sans facturation.
Pour les comptes créés à partir du 31 août 2026, l’API vérifie aussi que rien avant un bloc (prompt système, outils, messages) n’a changé depuis sa production, et renvoie un 400 dans le cas contraire.
Sur Amazon Bedrock, l’ancien outil computer_20251124 continue de fonctionner ; la migration vers le toolset ne concerne que l’API Claude et Google Cloud managed. Notre guide du computer use couvre le nouveau toolset.
Les deux changements silencieux
Le défaut d’effort passe à medium et le texte entre appels d’outils arrive dans des blocs thinking. Aucune requête n’échoue, mais vos coûts et votre interface changent. Les paramètres temperature, top_p et top_k restent non supportés, comme depuis Opus 4.7 ; la version d’API 2026-10-21 les rejette désormais sur tous les modèles.
Ma checklist de migration tient en six points : remplacer l’identifiant, supprimer tout thinking explicite, fixer effort et refaire le balayage, remplacer any/tool par auto + strict, régler thinking.display si votre interface affiche la progression, et comparer le champ usage sur une semaine de trafic réel.
Ce qu’il faut retenir
Opus 5.5 est le meilleur rapport performance/prix de la gamme Anthropic et, d’après les mesures indépendantes, le meilleur modèle disponible tout court à effort max. Avec 66,4 % sur Terminal-Bench 4.0, 1846 sur GDPval-AA et un score de 58 sur l’Intelligence Index d’Artificial Analysis, il devance Fable 5.1 et GPT-6 Astra sur la majorité des benchmarks, pour un tarif de base inférieur à celui d’Opus 5.
Mon avis : la migration depuis Opus 5 est recommandée, mais pas aveuglément. Le gain de 40 % annoncé est réel à effort medium et nul à effort max, où le modèle raisonne 63 % de plus pour un coût par tâche équivalent.
Les quatre ruptures d’API (thinking obligatoire, forced tool use refusé, blocs de thinking liés, ancien outil computer use rejeté) demandent une passe de code, pas un simple sed. Comptez une demi-journée pour une intégration moyenne, et une semaine de mesures avant de conclure sur la facture.
Face à Fable 5.1, le choix est désormais simple pour la plupart des équipes : commencez sur Opus 5.5 à medium, montez à high ou xhigh sur vos tâches difficiles, et ne passez à Fable 5.1 que si vos évaluations plafonnent encore. C’est la recommandation d’Anthropic elle-même, et c’est aussi la mienne. Pour les tâches à fort volume et bien définies, Sonnet 5.5 à 2 $ / 10 $ reste le complément logique dans une architecture à deux modèles.